
Los ASICs de LLM y los chips especializados para inferencia (por qué son importantes)
Los ASIC y los circuitos de silicio personalizados aumentan la velocidad y la eficiencia de la inferencia de LLM.
El futuro de la IA no se trata solo de modelos más inteligentes, sino de modelos capaces de razonar. También se trata del silicio que se adapta a la forma en que esos modelos se sirven realmente. El hardware especializado para la inferencia de LLM sigue un camino reminiscente de la transición de la minería de Bitcoin de las GPU a las ASIC diseñadas a medida, solo que con restricciones más duras porque los modelos y las recetas de precisión continúan evolucionando.
Para obtener más información sobre el rendimiento, la latencia, la VRAM y las comparativas (benchmarks) entre tiempos de ejecución y hardware, consulte Rendimiento de LLM: Comparativas, Cuellos de botella y Optimización.
 Electrical Imagination - LLM de texto a imagen Flux.
Por qué los LLM se benefician del hardware específico para inferencia
Los modelos de lenguaje grandes han transformado la IA, pero cada respuesta fluida depende de enormes flujos predecibles de operaciones matriciales y tráfico de memoria. A medida que el gasto en inferencia crece —a menudo superando al de entrenamiento a lo largo de la vida útil de un modelo—, los chips optimizados para el servicio, y no para cada carga de trabajo posible, se vuelven económicamente atractivos.
La analogía con la minería de Bitcoin es imperfecta pero instructiva. Ambas son tareas repetitivas y bien delimitadas donde eliminar la generalidad no utilizada del chip puede aportar grandes ganancias en throughput y julios por operación útil.
Lo que sugiere la historia de la minería de Bitcoin sobre las ASIC de inferencia
La minería de Bitcoin evolucionó a través de cuatro generaciones:
| Era | Hardware | Beneficio Clave | Limitación |
|---|---|---|---|
| 2015–2020 | GPU (CUDA, ROCm) | Flexibilidad | Alto consumo de energía, limitado por memoria |
| 2021–2023 | TPU, NPU | Especialización de grano grueso | Aún orientado al entrenamiento |
| 2024–2025 | ASIC de Transformers | Ajustado para inferencia de bajo bit | Generalidad limitada |
La IA está siguiendo un camino similar. Cada transición mejoró el rendimiento y la eficiencia energética en órdenes de magnitud.
Sin embargo, a diferencia de las ASIC de Bitcoin (que solo calculan SHA-256), las ASIC de inferencia necesitan cierta flexibilidad. Los modelos evolucionan, las arquitecturas cambian y los esquemas de precisión mejoran. El truco es especializarse justo lo suficiente: cablear de forma fija los patrones centrales manteniendo la adaptabilidad en los bordes.
Cómo difiere la inferencia de LLM del entrenamiento (y qué aprovechan los chips)
Las cargas de trabajo de inferencia exponen patrones que el hardware especializado puede atacar:
- Predomina la baja precisión — la aritmética de 8 bits, 4 bits, e incluso ternaria o binaria funciona bien para la inferencia
- La memoria es el cuello de botella — Mover pesos y cachés KV consume mucha más energía que la computación
- La latencia importa más que el throughput — Los usuarios esperan tokens en menos de 200 ms
- Paralelismo masivo de solicitudes — Miles de solicitudes de inferencia concurrentes por chip
- Patrones predecibles — Las capas de transformer están altamente estructuradas y pueden ser cableadas de forma fija
- Oportunidades de esparsidad — Los modelos utilizan cada vez más técnicas de poda y MoE (Mixture-of-Experts)
Un chip de inferencia diseñado a medida puede cablear de forma fija estos supuestos para lograr un rendimiento por vatio 10–50 veces mejor que las GPU de propósito general.
Quién está construyendo silicio de inferencia optimizado para LLM
El mercado de ASIC de inferencia abarca a empresas establecidas, diseños a escala de oblea y startups que apuestan por silicio con forma de transformer:
| Empresa | Chip / Plataforma | Especialidad |
|---|---|---|
| Groq | LPU (Language Processing Unit) | Throughput determinista para LLMs |
| Etched AI | Sohu ASIC | Motor de Transformer cableado fijo |
| Tenstorrent | Grayskull / Blackhole | ML general con malla de alto ancho de banda |
| Taalas | HC1 (producto Llama 3.1 8B) / hoja de ruta HC2 | Silicio “hardcore” específico de modelo; fusiona almacenamiento y cómputo |
| OpenAI × Broadcom | Chip de Inferencia Personalizado | Lanzamiento rumorado para 2026 |
| Intel | Crescent Island | GPU Xe3P solo para inferencia con 160GB de HBM |
| Cerebras | Wafer-Scale Engine (WSE-3) | Enorme ancho de banda de memoria en el chip |
Gran parte de esto ya está en centros de datos de producción, no en presentaciones. Equipos más pequeños como d-Matrix, Rain AI, Mythic y Tenet también están persiguiendo arquitecturas ajustadas para la inferencia de bajo bit y la esparsidad estructurada.
Taalas HC1, Chat Jimmy y el servicio ultra rápido de modelos pequeños
Taalas es un ejemplo reciente de la escuela de la “especialización casi total”. La empresa argumenta que la frontera entre memoria y cómputo (DRAM fuera del chip frente a SRAM dentro del chip) domina el costo, el consumo energético y la complejidad de ingeniería para la inferencia, y que el silicio por modelo —lo que ellos llaman Hardcore Models— puede colapsar esa frontera cuando una implementación está dispuesta a fijar los pesos y el grafo.
Su primer producto en venta, HC1, cablea de forma fija una variante de Llama 3.1 8B. Esa elección es pragmática: el modelo es lo suficientemente pequeño para implementarse rápidamente, está documentado de forma abierta y sigue siendo útil para muchas tareas de automatización, clasificación y redacción donde la profundidad de razonamiento bruto importa menos que la latencia y el costo. Taalas informa cifras del orden de 16k–17k tokens decodificados por segundo por usuario para esta configuración (la metodología del proveedor y las comparaciones aparecen en su informe), junto con afirmaciones de grandes ganancias en capital y energía frente a pilas de GPU convencionales para la misma clase de modelos. Las piezas de primera generación utilizan un almacenamiento mixto agresivo de bajo bit; la empresa describe su transición hacia formatos de coma flotante estándar de 4 bits en HC2 para recuperar margen de maniobra en calidad.
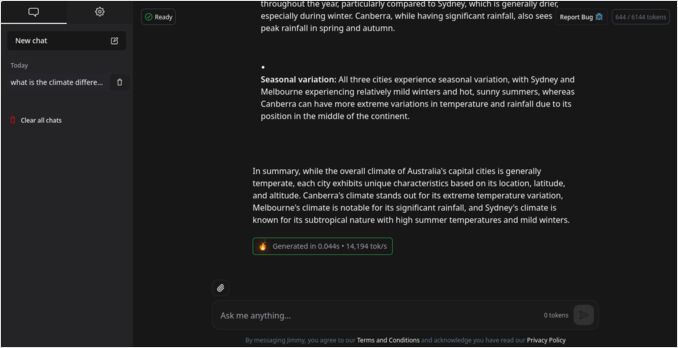
Para los desarrolladores que quieren sentir lo que implica esa clase de throughput en la práctica, Taalas ejecuta una demo gratuita de un bot de chat, Chat Jimmy, y ofrece acceso a la API mediante un formulario de solicitud en su sitio. Es explícitamente una demostración de concepto —no un asistente de frontera—, pero ilustra a una audiencia real que podría preferir un modelo modesto a “velocidad de cognición humana” frente a un modelo más grande que se sienta lento o caro.
Arquitectura de una ASIC de inferencia de transformer
¿Cómo se ve realmente un chip optimizado para transformers por dentro?
+--------------------------------------+
|         Interfaz de Host             |
|   (PCIe / CXL / NVLink / Ethernet)   |
+--------------------------------------+
|  Interconexión en el chip (malla/anillo)|
+--------------------------------------+
|  Baldosas de Cómputo / Núcleos        |
|   — Unidades de multiplicación matricial densa |
|   — ALUs de baja precisión (int8/int4)   |
|   — Unidades de Desquantización / Activación |
+--------------------------------------+
|  SRAM en el chip y búferes de caché KV |
|   — Pesos calientes, cachés fusionados     |
+--------------------------------------+
|  Pipelines de Quantización / Desquantización |
+--------------------------------------+
|  Planificador / Controlador           |
|   — Motor de ejecución de grafo estático   |
+--------------------------------------+
|  Interfaz DRAM / HBM fuera del chip   |
+--------------------------------------+
Las características arquitectónicas clave incluyen:
- Núcleos de cómputo — Unidades de multiplicación matricial densa optimizadas para operaciones int8, int4 y ternarias
- SRAM en el chip — Grandes búferes que contienen pesos calientes y cachés KV, minimizando los accesos costosos a DRAM
- Interconexiones de streaming — La topología de malla permite una escalado eficiente entre múltiples chips
- Motores de cuantización — Cuantización/desquantización en tiempo real entre capas
- Pila de compiladores — Traduce los grafos de PyTorch/ONNX directamente en microoperaciones específicas del chip
- Kernels de atención cableados fijos — Elimina la sobrecarga de flujo de control para softmax y otras operaciones
La filosofía de diseño refleja a las ASIC de Bitcoin: cada transistor sirve a la carga de trabajo específica. No hay silicio desperdiciado en funciones que la inferencia no necesita.
Comparativas entre GPU y ASIC para inferencia de LLM
Las cifras públicas representativas muestran cómo el hardware de inferencia especializado puede alejarse de las pilas de GPU de propósito general en las mismas familias de modelos (verifique siempre la metodología y los supuestos de lotes para sus propias cargas de trabajo):
| Modelo | Hardware | Throughput (tokens/s) | Tiempo al primer token | Multiplicador de Rendimiento |
|---|---|---|---|---|
| Llama-2-70B | NVIDIA H100 (8x DGX) | ~80–100 | ~1.7s | Línea base (1×) |
| Llama-2-70B | Groq LPU | 241–300 | 0.22s | 3–18× más rápido |
| Llama-3.3-70B | Groq LPU | ~276 | ~0.2s | 3× constante |
| Gemma-7B | Groq LPU | 814 | <0.1s | 5–15× más rápido |
| Llama-3.1-8B | Taalas HC1 (proveedor) | ~16k–17k tokens decodificados/s/usuario | — | Eje separado (grafo 8B fijo, no 70B) |
Fuentes: Groq.com, ArtificialAnalysis.ai, Blog del Desarrollador de NVIDIA; las cifras de Taalas HC1 provienen de la publicación de producto de la empresa.
Las filas centradas en Groq muestran ganancias grandes en throughput y tiempo al primer token frente a una línea base de GPU de alto rendimiento en modelos grandes. La fila de Taalas no es otro multiplicador contra esas líneas de 70B; ilustra hasta dónde puede empujarse la decodificación por usuario cuando el modelo y el grafo están fijados en silicio, a costa de la flexibilidad.
Compensaciones al especializar el silicio de inferencia
La especialización compra rendimiento, pero reintroduce el riesgo de producto e ingeniería:
-
Flexibilidad vs. Eficiencia. Una ASIC completamente fija atraviesa a toda velocidad los modelos de transformers de hoy, pero podría tener dificultades con las arquitecturas de mañana. ¿Qué pasa cuando los mecanismos de atención evolucionan o surgen nuevas familias de modelos? Eso no es una hipotética: los modelos de espacio de estado, los modelos de lenguaje de difusión y los modelos de mundo JEPA ya están desafiando la dominancia del transformer en el lado del modelo; consulte lo que viene después de los LLM para saber dónde podrían dejar al silicio de transformers cableado fijo.
-
Cuantización y Precisión. La menor precisión ahorra grandes cantidades de energía, pero gestionar la degradación de precisión requiere esquemas de cuantización sofisticados. No todos los modelos se cuantizan graciosamente a 4 bits o menos.
-
Ecosistema de Software. El hardware sin compiladores, kernels y marcos de trabajo robustos es inútil. NVIDIA aún domina en gran parte debido al ecosistema maduro de CUDA. Los nuevos fabricantes de chips deben invertir fuertemente en software.
-
Costo y Riesgo. Sacar a producción un chip cuesta decenas de millones de dólares y lleva de 12 a 24 meses. Para las startups, esta es una apuesta masiva en supuestos arquitectónicos que podrían no sostenerse.
Aun así, a escala hipernumeraria, incluso las ganancias de eficiencia de 2× se traducen en miles de millones en ahorros. Para los proveedores de nube que ejecutan millones de solicitudes de inferencia por segundo, el silicio personalizado se vuelve cada vez más innegociable.
Especificación deseada para un chip de inferencia de LLM
| Característica | Especificación Ideal |
|---|---|
| Proceso | Nodo de 3–5nm |
| SRAM en chip | 100MB+ acoplado herméticamente |
| Precisión | Soporte nativo int8 / int4 / ternary |
| Throughput | 500+ tokens/seg (modelo 70B) |
| Latencia | <100ms tiempo al primer token |
| Interconexión | Malla de baja latencia o enlaces ópticos |
| Compilador | Herramienta PyTorch/ONNX → microcódigo |
| Energía | <0.3 julios por token |
Mirando hacia adelante (2026–2030)
Espere que el paisaje del hardware de inferencia se estratifique en tres niveles gruesos:
-
Chips de Entrenamiento. Las GPU de gama alta como NVIDIA B200 y AMD Instinct MI400 continuarán dominando el entrenamiento con su flexibilidad FP16/FP8 y su enorme ancho de banda de memoria.
-
ASIC de Inferencia. Los aceleradores de transformers cableados fijos y de baja precisión manejarán el servicio de producción a escala hipernumeraria, optimizados para costo y eficiencia.
-
NPU de Borde. Chips pequeños y ultra eficientes llevarán LLMs cuantizados a teléfonos inteligentes, vehículos, dispositivos IoT y robots, habilitando la inteligencia en el dispositivo sin dependencia de la nube.
Más allá del hardware por sí solo, veremos:
- Clústeres híbridos — GPU para entrenamiento flexible, ASIC (o motores de inferencia a escala de oblea) para un servicio eficiente
- Inferencia como Servicio — Los hiperescaladores mezclan aceleradores de primera parte (AWS Inferentia, Google TPU, y otros) con GPU
- Diseño conjunto de hardware y software — Modelos formateados para esparsidad de bloques, enrutamiento MoE y capas amigables para la cuantización
- Silicio por modelo o por familia — Empresas como Taalas que apuestan por que algunas implementaciones intercambiarán la flexibilidad arquitectónica por un costo y una latencia extremos en un grafo conocido
- APIs de inferencia abiertas — Presión para mantener las interfaces de servicio portátiles incluso cuando el silicio no lo es
Pensamientos finales
La “ASICización” de la inferencia de IA ya está en marcha. Así como la minería de Bitcoin evolucionó de las CPU a silicio especializado, la implementación de IA está siguiendo el mismo camino.
La próxima revolución en la IA no será sobre modelos más grandes —será sobre chips mejores. El hardware optimizado para los patrones específicos de la inferencia de transformers determinará quién puede implementar la IA económicamente a escala.
Así como los mineros de Bitcoin optimizaron cada vatio desperdiciado, el hardware de inferencia exprimirá cada último FLOP por julio. Cuando eso ocurra, el verdadero avance no estará en los algoritmos —estará en el silicio que los ejecuta.
El futuro de la IA está siendo grabado en silicio, un transistor a la vez.
Para más comparativas, opciones de hardware y ajuste de rendimiento, consulte nuestro Centro de Rendimiento de LLM: Comparativas, Cuellos de botella y Optimización.
Enlaces Útiles
- Comparativas Oficiales de Groq
- Taalas — El camino hacia la IA ubicua (HC1, hoja de ruta, filosofía)
- Chat Jimmy — Demo de Llama 3.1 8B de Taalas
- Formulario de solicitud de acceso a la API de Taalas
- Artificial Analysis - Tabla de clasificación de rendimiento de LLM
- Breve Técnico de NVIDIA H100
- Etched AI - Anuncio de ASIC de Transformer
- Cerebras Wafer-Scale Engine
- Precios de las NVidia RTX 5080 y RTX 5090 en Australia - Octubre 2025
- Rendimiento de LLM y Pines PCIe: Consideraciones clave
- Prueba de velocidad de Modelos de Lenguaje Grandes
- Comparando la idoneidad de las GPU NVidia para IA
- ¿Es bueno el Quadro RTX 5880 Ada 48GB?
