
Qwen 3.6 27B y 35B MTP frente a Standard en GPU de 16 GB
MTP frente a la decodificación estándar en RTX 4080 — benchmarks reales
Probé el rendimiento de la decodificación especulativa (Predicción Multi-token, MTP) en Qwen 3.6 27B y 35B en una RTX 4080 con 16 GB de VRAM.
Para una visión más amplia de las velocidades de tokens y las compensaciones de VRAM entre más modelos en el mismo hardware, consulte Benchmarks de LLM con llama.cpp en 16 GB de VRAM.
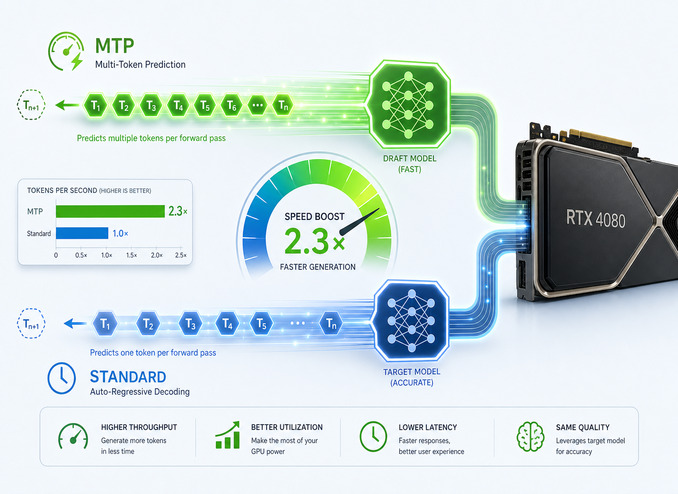
Qué es MTP (Predicción Multi-token)
La Predicción Multi-token es una forma de decodificación especulativa integrada directamente en ciertos puntos de control (checkpoints) de modelos. En lugar de predecir un token por pasada hacia adelante, el modelo lleva cabezas “MTP” adicionales que proponen varios tokens futuros en un solo paso y luego los verifica en paralelo. Si las conjeturas se aceptan, la eficiencia de transferencia efectiva aumenta sin cambiar la calidad de la salida.
La familia Qwen 3.6 incluye archivos GGUF estándar y variantes habilitadas para MTP. En llama.cpp, MTP se activa mediante:
--spec-type draft-mtp --spec-draft-n-max 3
--spec-draft-n-max es la perilla de ajuste clave. Establece cuántos tokens especulativos la cabeza MTP propone en cada paso. Los valores más altos ofrecen una posible mejora de velocidad pero cuestan VRAM extra para los buffers de borrador, lo cual es una restricción real en tarjetas de 16 GB.
Qué y cómo probé
Probé cómo se comportan los dos modelos Qwen 3.6 con MTP habilitado versus la decodificación estándar en una GPU con 16 GB de VRAM (RTX 4080).
Para ajustar los pesos del modelo y la caché KV en la VRAM, usé variantes fuertemente cuantizadas:
Qwen3.6-27B-UD-IQ3_XXSyQwen3.6-27B-UD-IQ3_XXS-MTPQwen3.6-35B-A3B-UD-IQ3_SyQwen3.6-35B-A3B-UD-IQ3_S-MTP
Se rastrean dos presupuestos de contexto por ejecución:
- Ctx Prom — el tamaño de contexto en el que llama.cpp ocupa ~14.8 GB de VRAM, dejando a otras aplicaciones (Xorg, GNOME Shell, Cursor) un buffer cómodo de ~500 MB.
- Ctx Máx — el mayor contexto que llama.cpp podría asignar dado que las mismas aplicaciones de escritorio ya ocupan ~500 MB de VRAM.
Una razón clave para mantener el contexto promedio en un objetivo práctico es que Hermes Agent — que uso como asistente de IA principal que se conecta a llama.cpp en esta máquina — requiere al menos 64 K de contexto por defecto y rechazará los modelos con una ventana más pequeña al inicio. Los modelos por debajo de ese umbral no pueden mantener suficiente memoria de trabajo para flujos de trabajo de llamadas a herramientas de múltiples pasos. Para llama.cpp, esto significa pasar --ctx-size 65536 o mayor. Cualquier configuración de MTP que comprima el contexto utilizable promedio significativamente por debajo de 64 K es, por lo tanto, inadecuada para cargas de trabajo diarias de Hermes, razón por la cual los números de Ctx Prom en las tablas a continuación son los más relevantes para la toma de decisiones.
Se probaron ambos niveles de cuantización de caché KV: q8 (mayor calidad, más VRAM) y q5 (menos VRAM, contexto más largo). Tenga en cuenta que pasar de la caché KV q8 a q5 puede causar una disminución notable en la calidad: en mis pruebas, la degradación fue suficiente como para hacer que q5 no fuera adecuada para mis cargas de trabajo. Los números de velocidad y contexto para q5 se incluyen por completitud, pero debe probar la calidad de la respuesta en sus propias tareas antes de comprometerse con ella.
Qwen 3.6 27B MTP vs Estándar
Caché KV q8
| MTP máx 1 | MTP máx 2 | MTP máx 3 | MTP máx 4 | Estándar (IQ3_XXS) | |
|---|---|---|---|---|---|
| Vel. Prompt | 148 t/s | 151 t/s | 148 t/s | 147 t/s | 200 t/s |
| Vel. Gen | 65 t/s | 75 t/s | 73 t/s | 75 t/s | 45 t/s |
| Ctx Prom | 40 K | 40 K | 40 K | 30 K | 80 K |
| Ctx Máx | 60 K | 60 K | 60 K | 50 K | 100 K |
Con la caché KV q8, MTP en --spec-draft-n-max 2 ofrece una generación ~67 % más rápida (75 vs 45 t/s) a costa de reducir la ventana de contexto promedio a la mitad, de 80 K a 40 K. La velocidad de ingesta del prompt baja de 200 a ~150 t/s porque MTP requiere transferencias de dispositivo a host durante la fase de prellenado (prefill).
Caché KV q5
| MTP máx 1 | MTP máx 2 | MTP máx 3 | MTP máx 4 | Estándar (IQ3_XXS) | |
|---|---|---|---|---|---|
| Vel. Prompt | 145 t/s | 144 t/s | 141 t/s | 139 t/s | 191 t/s |
| Vel. Gen | 57 t/s | 62 t/s | 67 t/s | 66 t/s | 41 t/s |
| Ctx Prom | 70 K | 60 K | 60 K | 50 K | 130 K |
| Ctx Máx | 100 K | 100 K | 90 K | 80 K | 160 K |
Cambiar a la caché KV q5 recupera un contexto significativo: --spec-draft-n-max 1 da un contexto promedio de 70 K a 57 t/s, lo que es una aceleración de generación del 39 % sobre la decodificación estándar, manteniendo la ventana de contexto en un tamaño útil. En --spec-draft-n-max 3, el contexto baja a 60 K, pero la generación alcanza 67 t/s (+63 %).
Conclusión para Qwen 3.6 27B
MTP es genuinamente útil para el modelo denso de 27B. El punto óptimo en 16 GB de VRAM es:
- KV q8 +
--spec-draft-n-max 2— la mejor velocidad cruda (75 t/s), contexto reducido a 40–60 K - KV q5 +
--spec-draft-n-max 1— el mejor equilibrio entre velocidad y contexto (57 t/s, 70 K de contexto promedio)
Qwen 3.6 35B MTP vs Estándar
El modelo de 35B es una arquitectura de Mezcla de Expertos (MoE) (35B-A3B significa 35B parámetros totales, ~3B activos por token). Los modelos MoE suelen beneficiarse más de MTP porque el enrutamiento esparsal mantiene la cabeza MTP computacionalmente barata en comparación con una pasada hacia adelante completa.
Caché KV q8
| MTP máx 1 | MTP máx 2 | MTP máx 3 | MTP máx 4 | Estándar (IQ3_S) | |
|---|---|---|---|---|---|
| Vel. Prompt | 277 t/s | 277 t/s | 265 t/s | 275 t/s | 368 t/s |
| Vel. Gen | 186 t/s | 189 t/s | 180 t/s | 171 t/s | 146 t/s |
| Ctx Prom | 15 K | 10 K | — | — | 80 K |
| Ctx Máx | 80 K | 70 K | 60 K | 50 K | 150 K |
La arquitectura MoE ofrece una velocidad de generación cruda impresionante con MTP (+27 % en máx 1, +29 % en máx 2 vs 146 t/s estándar). Pero el problema práctico es el contexto promedio. Con la caché KV q8, incluso --spec-draft-n-max 1 solo da 15 K de contexto promedio, apenas suficiente para tareas modestas. Las profundidades de borrador más altas no tienen un contexto promedio viable en absoluto en una tarjeta de 16 GB.
Esta es la pregunta central sobre el costo de VRAM para MTP en hardware de consumo: los buffers de borrador adicionales consumen directamente el presupuesto de VRAM restante, y el modelo 35B-A3B con la caché KV q8 deja muy poco margen.
Caché KV q5
| MTP máx 1 | MTP máx 2 | MTP máx 3 | MTP máx 4 | Estándar (IQ3_S) | |
|---|---|---|---|---|---|
| Vel. Prompt | 264 t/s | 266 t/s | 270 t/s | 264 t/s | 343 t/s |
| Vel. Gen | 151 t/s | 147 t/s | 137 t/s | 131 t/s | 122 t/s |
| Ctx Prom | 10 K | — | — | — | 120 K |
| Ctx Máx | 120 K | 110 K | 110 K | 80 K | 200 K |
La caché KV q5 solo mejora marginalmente la situación del contexto promedio. --spec-draft-n-max 1 da 10 K de contexto promedio a 151 t/s. La decodificación estándar en q5 da 122 t/s con 120 K de contexto promedio.
Conclusión para Qwen 3.6 35B
En una GPU de 16 GB, el modelo MoE de 35B con MTP se enfrenta a un muro duro: el contexto utilizable promedio colapsa a 10–15 K tokens, lo que lo hace impráctico para cargas de trabajo reales. La decodificación estándar a 122–146 t/s con 80–120 K de contexto es significativamente más útil.
Si tiene 24 GB+ de VRAM, la combinación de 35B + MTP se vuelve mucho más atractiva: el problema de la ventana de contexto desaparece y mantiene el beneficio de velocidad.
Cómo elegir el valor correcto de --spec-draft-n-max
La pregunta de cuántos tokens especulativos proponer por paso (--spec-draft-n-max) no tiene una única respuesta correcta; depende tanto de la arquitectura del modelo como de la VRAM disponible:
- Para 27B denso en 16 GB:
--spec-draft-n-max 2con KV q8 es el más rápido,--spec-draft-n-max 1con KV q5 es el más amigable con el contexto. - Para 35B MoE en 16 GB:
--spec-draft-n-max 1es la única opción que mantiene cualquier contexto utilizable, y aun así solo marginalmente. - Los valores más altos (
3,4) aumentan la presión sobre la VRAM sin ganancias proporcionales de velocidad: en máx 4 gasta aproximadamente la misma VRAM extra que en máx 2, pero la velocidad de generación no sigue el ritmo.
Cómo habilitar MTP en llama.cpp
Asegúrese de usar un GGUF habilitado para MTP (el nombre del archivo contiene MTP). Si es nuevo en las banderas de llama.cpp, el Inicio rápido de llama.cpp con CLI y Servidor cubre todos los fundamentos. Luego inicie llama-server o llama-cli con:
llama-server \
  --model Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf \
  --ctx-size 40000 \
  -ngl 99 --flash-attn on \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --spec-type draft-mtp \
  --spec-draft-n-max 2
Para la caché KV q5, reemplace q8_0 con q5_1 o q5_0 y ajuste --ctx-size hacia arriba:
llama-server \
  --model Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf \
  --ctx-size 80000 \
  -ngl 99 --flash-attn on \
  --cache-type-k q5_1 --cache-type-v q5_1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 1
MTP se activa automáticamente una vez que llama.cpp ve las cabezas MTP en el archivo GGUF y se establece --spec-type draft-mtp.
Por lo tanto, el Qwen3.6-27B-UD-IQ3_XXS.gguf estándar no funcionará en modo MTP; necesitará Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf.
Pero el Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf puede funcionar tanto en modo de decodificación especulativa como en el autoregresivo.
Conclusión
En una GPU de 16 GB (RTX 4080), con estas cuantizaciones, MTP de llama.cpp es una clara victoria para Qwen 3.6 27B y un resultado neto negativo para Qwen 3.6 35B en el uso práctico:
Qwen 3.6 27B (IQ3_XXS) — MTP vale la pena:
- KV q8 + MTP máx 2 → ~67 % de generación más rápida, contexto 40–60 K (vs 80–100 K sin MTP)
- KV q5 + MTP máx 1 → ~39 % de generación más rápida, contexto 70–100 K (vs 130–160 K sin MTP)
- Buen equilibrio entre velocidad y eficiencia de VRAM con
--spec-draft-n-max 2
Qwen 3.6 35B (IQ3_S) — MTP no es práctico en 16 GB:
- La velocidad de generación es 27–29 % más alta, pero el contexto promedio colapsa a 10–15 K en q8 y 10 K en q5
- La decodificación estándar a 122–146 t/s con 80–120 K de contexto es más útil para tareas reales
- La situación mejora sustancialmente en VRAM de 24 GB+
En papel, la caché KV q5 es la respuesta obvia para maximizar la ventana de contexto manteniendo las ganancias de velocidad de MTP, pero en la práctica, la caída de calidad al pasar de q8 a q5 puede ser significativa. Pruebe q5 en sus propias tareas antes de adoptarlo; para mis cargas de trabajo, la degradación fue inaceptable, y q8 con un presupuesto de contexto más ajustado sigue siendo el mejor compromiso.
Para la imagen general de las opciones de servicio de LLM y las compensaciones de infraestructura, consulte el pilar Hospedaje de LLM en 2026 y Rendimiento de LLM en 2026. Dónde se ubica esta clase de 27B en el espectro de tamaño y costo de 2026, y por qué una compilación Qwen3.8-27B Q4 actual desea una tarjeta de 24 GB mientras que las mediciones anteriores permanecen en 16 GB, está en La Frontera Eficiente de Modelos Abiertos en 2026. Si está ajustando los ajustes del muestreador de Qwen 3.6 junto con MTP, la Referencia de Parámetros de Inferencia Agéntica de LLM para Qwen 3.6 y Gemma 4 es un compañero útil.
