
Claude, OpenClaw e o fim da cobrança plana para agentes
As assinaturas do Claude já não alimentam agentes
A brecha silenciosa que impulsionou uma onda de experimentação com agentes agora está fechada.
As assinaturas do Claude já não alimentam agentes
A brecha silenciosa que impulsionou uma onda de experimentação com agentes agora está fechada.
Busca de IA auto-hospedada com LLMs locais
O Vane é uma das entradas mais pragmáticas no espaço de “busca com IA e citações”: um motor de respostas self-hosted que combina recuperação web em tempo real com LLMs locais ou na nuvem, mantendo toda a pilha sob seu controle.
Codificação agentiva, agora com backends de modelos locais.
O Claude Code não é um autocompletar com melhor marketing. É uma ferramenta de codificação agêntica: lê sua base de código, edita arquivos, executa comandos e integra-se às suas ferramentas de desenvolvimento.
Instalação e introdução rápida do Hermes Agent para desenvolvedores
O Hermes Agent é um assistente de IA auto-hospedado, agnóstico em relação ao modelo, que roda em uma máquina local ou em um VPS de baixo custo, funciona através de interfaces de terminal e mensagens, e melhora ao longo do tempo transformando tarefas repetidas em habilidades reutilizáveis.
Instale o TGI, desenvolva rapidamente e depure ainda mais rápido.
A Inferência de Geração de Texto (TGI) tem uma energia muito específica. Não é o mais novo na rua da inferência, mas é aquele que já aprendeu como a produção quebra -
Velocidade de tokens do llama.cpp em 16 GB de VRAM (tabelas).
Aqui estou comparando a velocidade de vários LLMs executados em uma GPU com 16GB de VRAM, e escolhendo o melhor para auto-hospedagem.
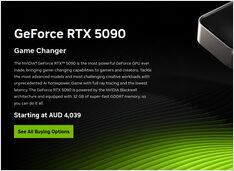
A RTX 5090 está escassa e com preço inflado na Austrália.
A Austrália tem estoque de RTX 5090. Quase nada. E se você encontrar uma, pagará um prêmio que parece descolado da realidade.
Acesso remoto ao Ollama sem portas públicas
Ollama está em seu melhor quando é tratado como um daemon local: a CLI e seus aplicativos se comunicam com uma API HTTP em loopback, e o resto da rede nunca fica sabendo que ele existe.
Servidor Ollama com prioridade na criação, GPU e persistência.
Ollama funciona muito bem em hardware nativo. Ele fica ainda mais interessante quando o tratamos como um serviço: um endpoint estável, versões fixas, armazenamento persistente e uma GPU que está disponível ou simplesmente não está.
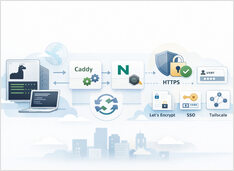
HTTPS Ollama sem interromper as respostas em streaming.
Executar o Ollama atrás de um proxy reverso é a maneira mais simples de obter HTTPS, controle de acesso opcional e comportamento de streaming previsível.
Embeddings RAG - Python, Ollama, APIs da OpenAI.
Se você está estudando geração aumentada por recuperação (RAG), esta seção explica embeddings de texto de forma simples — o que são, como se encaixam na pesquisa e recuperação, e como chamar duas configurações locais comuns em Python usando Ollama ou uma API HTTP compatível com OpenAI (como muitos servidores baseados em llama.cpp expõem).
Execute modelos abertos com rapidez usando o SGLang.
O SGLang é um framework de serviço de alto desempenho para grandes modelos de linguagem e modelos multimodais, construído para fornecer inferência de baixa latência e alto throughput, desde uma única GPU até clusters distribuídos.
Troque modelos de LLM locais a quente sem alterar os clientes.
Em breve, você estará alternando entre vLLM, llama.cpp e mais — cada pilha em sua própria porta. Tudo a jusante ainda quer uma única URL base /v1; caso contrário, você continuará trocando portas, perfis e scripts pontuais. O llama-swap é o proxy /v1 antes dessas pilhas.
A maioria dos ambientes locais de IA começa com um modelo e um runtime.
O que realmente ocorre quando você executa o Ultrawork.
Oh My Opencode promete uma “equipe de desenvolvedores de IA virtual” — Sisyphus orquestrando especialistas, tarefas executando em paralelo e a mágica palavra-chave ultrawork ativando tudo isso.
Teste do LLM OpenCode — estatísticas de codificação e precisão
Testei como o OpenCode funciona com vários LLMs hospedados localmente no Ollama e llama.cpp, e, para comparação, adicionei alguns modelos gratuitos do OpenCode Zen.