Memória com retrospectiva para o Agente Hermes: armazenamento de memória auto-hospedado com LLMs locais
Memória persistente do Hermes no seu próprio hardware.
Um agente de IA auto-hospedado precisa de mais do que uma janela de contexto longa. Ele precisa de uma forma de reter fatos úteis, recuperar decisões anteriores e revisar aquilo que acredita saber à medida que os projetos evoluem.
O Hermes Agent vem com arquivos de memória embutidos, mas um provedor externo pode oferecer uma recuperação muito mais rica entre sessões. O Hindsight é uma das opções mais interessantes nesse espaço. Este guia instala-o para o Hermes sem inferência em nuvem, primeiro como um contêiner Docker tudo-em-um e depois contra um servidor PostgreSQL existente com endpoints de modelos locais separados.
O guia cobre a implantação, a escolha e a configuração de modelos locais de incorporação (embeddings), reordenação (reranking) e geração, o controle do que o auto-retain escreve no banco, a conexão com o Hermes e a camada operacional: backup, migração e higiene diária do banco. Os exemplos usam um esquema de portas deliberado — 8080 para o servidor principal llama.cpp, 8081 para embeddings, 8082 para reranking, 11434 para Ollama — então altere-as para as portas que você já usa e mantenha os pequenos servidores fora da porta do modelo principal.
O que o Hindsight Faz
O Hindsight é um motor de memória persistente para agentes com três operações principais: retain (reter), recall (recordar) e reflect (refletir). Retain extrai e armazena informações; recall combina recuperação semântica, por palavras-chave, por grafo e temporal; reflect sintetiza uma resposta a partir de memórias acumuladas. A consolidação em segundo plano pode transformar observações sobrepostas em uma camada de conhecimento mais útil.
Não é apenas um banco de embeddings. Um banco vetorial pode localizar passagens semelhantes, mas um sistema de memória também precisa preservar cronologia, fronteiras de projeto, evidências contraditórias e mudanças em decisões. Esses modos de falha são explorados em laços de memória auto-reforçados.
Para o mercado mais amplo, veja provedores de memória para agentes comparados. O MEMORY.md, USER.md e os modos de memória embutidos do Hermes são cobertos no guia do sistema de memória do Hermes Agent, portanto este artigo assume que você sabe como a camada embutida funciona.
Por que ir além do Mnemosyne
Mnemosyne para Hermes oferece ideias locais atraentes, incluindo armazenamento SQLite e recuperação híbrida. Na prática, restrições de instalação, compatibilidade de versão, comportamento de aprovação de escrita e mudanças rápidas em torno de seus pré-lançamentos 4.0 podem dificultar a operação previsível. Essas são preocupações operacionais, não evidência de que o modelo de memória do Mnemosyne é fundamentalmente falho.
O Hindsight também não está livre de dependências: sua imagem Docker e modelos locais podem consumir bastante espaço em disco. Executar sua API como um serviço independente, com inferência em outro lugar, mantém atualizações e solução de problemas isolados do próprio agente.
Escolha uma Implantação
| Componente | A: Contêiner tudo-em-um | B: Servidor PostgreSQL existente |
|---|---|---|
| API e UI do Hindsight | Contêiner Docker | Contêiner Docker |
| PostgreSQL | pg0 embutido no contêiner |
Máquina PostgreSQL existente |
| LLM Generativo | llama.cpp externo | llama.cpp externo |
| Embeddings | Padrão local ou externo | Ollama ou llama.cpp externo |
| Reranking | Padrão local ou externo | Servidor de rerank externo |
| Ideal para | Avaliação rápida | Instalação de longa duração, isolada |
Aqui, “tudo-em-um” significa que a API do Hindsight, a UI e o banco de dados estão em um único contêiner; o LLM de inferência ainda é hospedado em outro lugar. Isso é intencional: a imagem oficial do Docker do Hindsight não inclui um servidor llama.cpp gerativo local pronto para uso.
Use endereços acessíveis pela LAN, não localhost, para serviços executados em um host diferente. Restrinja essas portas a clientes confiáveis; as chaves dummy de exemplo são placeholders de compatibilidade, não autenticação.
Opção A: Contêiner Hindsight Tudo-em-Um
Esta é a maneira mais simples de avaliar o Hindsight sem encher a VM do Hermes com Python, Torch e dependências de modelos locais. O contêiner executa o Hindsight e o PostgreSQL embutido, enquanto seu LLM llama.cpp principal lida com a extração de memória e reflexão.
Duas tags de imagem importam aqui. ghcr.io/vectorize-io/hindsight:latest é a imagem grande — aproximadamente 9 GB em AMD64 — porque ela inclui um embutidor BGE, um reordenador MiniLM e o PostgreSQL embutido. latest-slim é de aproximadamente 500 MB e espera que esses dois modelos estejam em outro lugar, o que é o que você quer uma vez que você aponte o Hindsight para a configuração de embedding e reranking em Servir e Conectar Modelos Locais. Uma vez que a verificação de saúde passe, fixe uma tag específica: uma tag móvel é uma correspondência ruim para um banco de dados que você pretende manter.
Crie um diretório e um arquivo Compose no host do Hindsight:
mkdir -p ~/services/hindsight
cd ~/services/hindsight
cat > compose.yaml <<'YAML'
services:
  hindsight:
    image: ghcr.io/vectorize-io/hindsight:latest
    container_name: hindsight
    restart: unless-stopped
    shm_size: 1gb
    extra_hosts:
      - "host.docker.internal:host-gateway"
    ports:
      - "8888:8888"  # API de Memória
      - "9999:9999"  # UI de plano de controle
    environment:
      HINDSIGHT_API_WORKER_ID: hindsight-standalone
      HINDSIGHT_API_LLM_PROVIDER: openai
      HINDSIGHT_API_LLM_BASE_URL: http://IP_ESTACAO_DE_TRABALHO:8080/v1
      HINDSIGHT_API_LLM_MODEL: LocalMegaLLM
      HINDSIGHT_API_LLM_API_KEY: dummy
      HINDSIGHT_API_LLM_MAX_CONCURRENT: "2"
    volumes:
      - hindsight-pg0:/home/hindsight/.pg0
volumes:
  hindsight-pg0:
YAML
Substitua IP_ESTACAO_DE_TRABALHO pelo host que executa o llama.cpp. No Linux, host.docker.internal se resolve apenas se o contêiner declarar o mapeamento host-gateway mostrado acima; sem isso, uma URL base de http://host.docker.internal:8080/v1 não aponta para lugar nenhum. A reserva de 1 GB de memória compartilhada é particularmente útil para indexação do PostgreSQL embutido; o /dev/shm padrão pequeno do Docker pode causar falhas. Um volume nomeado preserva o banco de dados quando o contêiner é recriado, e uma alternativa de bind mount deve ser possuída pelo uid 1000, o usuário dentro da imagem.
HINDSIGHT_API_WORKER_ID deve permanecer estável entre recriações — o padrão do Docker é o nome do host do contêiner, e uma tarefa que estava em andamento quando um contêiner morreu permanece travada sob o antigo id do trabalhador.
docker compose up -d
docker compose logs -f --tail=100
curl -f http://localhost:8888/health
Se sua versão instalada do Hindsight expõe a saúde em um caminho diferente, inspecione http://localhost:8888/docs e os logs do contêiner. O plano de controle normalmente está disponível em http://HOST_HINDSIGHT:9999. Uma vez que a implantação básica funcione, você também pode apontar seus provedores de embedding e reranking para a configuração em Servir e Conectar Modelos Locais, em vez de carregar os modelos padrão dentro do contêiner.
Não exponha as portas 8888 ou 9999 diretamente para a internet. Use uma rede privada ou um proxy reverso autenticado. O PostgreSQL embutido é conveniente para testes, mas um banco de dados gerenciado externamente é mais fácil de fazer backup e manter.
Opção B: Hindsight Contra um Servidor PostgreSQL Existente
Para uma instalação de longa duração, prefiro manter a API do Hindsight, o banco de dados e os endpoints de inferência separados. A VM do Hindsight pode permanecer pequena porque ela executa orquestração e serviços HTTP em vez de modelos pesados.
Preparar PostgreSQL e pgvector
O Hindsight precisa de PostgreSQL 14 ou mais recente e de uma extensão de vetores no banco de dados hindsight. A extensão é por banco de dados: instalar o pacote no servidor não faz nada até CREATE EXTENSION ser executado lá. Em um servidor PostgreSQL Debian ou Ubuntu, instale o pacote pgvector correspondente à versão principal real do PostgreSQL; por exemplo, no PostgreSQL 16:
sudo apt update
sudo apt install postgresql-16-pgvector
O nome do pacote e a disponibilidade dependem dos repositórios apt configurados. Se não estiver disponível, siga as instruções de instalação do pgvector, ou instale um pacote compatível do repositório PGDG do PostgreSQL. Não altere a versão principal do PostgreSQL em um servidor compartilhado às cegas.
Crie um papel (role) e um banco de dados dedicados como administrador do PostgreSQL:
CREATE ROLE hindsight LOGIN PASSWORD 'SUBSTITUA_COM_SENHA_LONGA';
CREATE DATABASE hindsight OWNER hindsight;
Conecte-se ao novo banco de dados e habilita a extensão:
sudo -u postgres psql -d hindsight -c \
  'CREATE EXTENSION IF NOT EXISTS vector;'
sudo -u postgres psql -d hindsight -c \
  "SELECT extname, extversion FROM pg_extension WHERE extname = 'vector';"
A extensão normalmente precisa de privilégios elevados para instalar; o papel da aplicação não precisa ser um superusuário. O Hindsight usa pgvector por padrão e deseja 0.8.0 ou mais recente para varreduras ANN iterativas; servidores mais antigos rejeitam essa configuração. HINDSIGHT_API_VECTOR_EXTENSION pode alternativamente selecionar pgvectorscale (uma opção DiskANN que o Hindsight documenta para bancos muito grandes) ou vchord, ambos dos quais precisam de empacotamento extra nesta build exata do PostgreSQL. Alterar algoritmos após as existirem memórias para a inicialização e pede por uma migração, então escolha antes do primeiro retain. Para um banco pessoal do Hermes, o pgvector é o que se deve instalar e então parar.
Permita apenas o host do Hindsight através do pg_hba.conf, por exemplo:
host hindsight hindsight 192.168.1.50/32 scram-sha-256
Defina listen_addresses do PostgreSQL apropriadamente e use TLS ou uma rede privada confiável para conexões entre hosts. Faça backup deste banco de dados independentemente do contêiner Docker do Hindsight. Se o servidor é compartilhado com outras aplicações, mantenha o Hindsight em seu próprio banco de dados, ou defina HINDSIGHT_API_DATABASE_SCHEMA para um esquema que você possua; o esquema padrão é public.
Executar Hindsight Contra PostgreSQL
Crie compose.yaml na VM do Hindsight. Esta versão deliberadamente não inicia o PostgreSQL localmente:
services:
  hindsight:
    image: ghcr.io/vectorize-io/hindsight:latest-slim
    restart: unless-stopped
    ports:
      - "8888:8888"
      - "9999:9999"
    env_file: .env
    environment:
      HINDSIGHT_API_LLM_PROVIDER: openai
      HINDSIGHT_API_LLM_BASE_URL: http://IP_ESTACAO_DE_TRABALHO:8080/v1
      HINDSIGHT_API_LLM_MODEL: LocalMegaLLM
      HINDSIGHT_API_LLM_API_KEY: dummy
      HINDSIGHT_API_LLM_MAX_CONCURRENT: "2"
      HINDSIGHT_API_DB_POOL_MIN_SIZE: "2"
      HINDSIGHT_API_DB_POOL_MAX_SIZE: "10"
      HINDSIGHT_API_WORKER_ID: hindsight-standalone
Armazene a URL do banco de dados externo em um arquivo chamado .env:
HINDSIGHT_API_DATABASE_URL=postgresql://hindsight:SUA_SENHA@IP_POSTGRES:5432/hindsight
chmod 600 .env
docker compose up -d
docker compose logs -f --tail=100
Se sua senha contém @, :, / ou outros caracteres reservados de URL, faça a codificação URL antes de colocá-la na string de conexão. Teste se a VM do Hindsight pode alcançar a porta 5432 do PostgreSQL, e se pg_hba.conf permite o host do Hindsight — um servidor vinculado apenas a 127.0.0.1 recusa a conexão mesmo quando a URL parece correta. Permita que a primeira inicialização execute migrações do banco de dados; migrações rodam na inicialização a menos que você defina HINDSIGHT_API_RUN_MIGRATIONS_ON_STARTUP=false. Com a API e o banco de dados no ar, continue com Escolher Modelos para Hindsight e Servir e Conectar Modelos Locais antes de conectar o Hermes.
Escolher Modelos para Hindsight
A implantação coloca a API e o banco de dados na rede. A próxima decisão é quais modelos preenchem os três papéis de inferência: embeddings para candidatos de recall, um reordenador para reordená-los e um LLM gerativo para retain, reflect e consolidação. Um padrão prático para um host CPU do Hindsight cuja GPU já está ocupada com conversa é Qwen/Qwen3-Embedding-0.6B no processo, BAAI/bge-reranker-v2-m3 no processo, e um modelo de chat llama.cpp compartilhado para trabalho gerativo.
Modelos de Embedding
O Hindsight lê a dimensão do embedding na inicialização e dimensiona o banco para corresponder, então o modelo que você escolhe no primeiro retain é o modelo que o banco mantém até você reconstruí-lo. A dimensionalidade e o comportamento de instrução importam mais do que o ranking do placar de classificação: um embutidor 8B mais forte não vale uma migração se o banco já for de 384 ou 1024 dimensões. As linhas abaixo são ordenadas da mais leve à mais pesada; as figuras de RAM são aproximadas do pé de carga em CPU (FP16 / carregamento local típico), não o tamanho do arquivo GGUF.
| Modelo | Parâmetros | Dim | Contexto | Carregado | Roda em | Notas |
|---|---|---|---|---|---|---|
BAAI/bge-small-en-v1.5 |
33M | 384 | 512 | ~100–130 MB | CPU | Padrão do Hindsight; vem no hindsight:latest. Caminho local mais rápido. A distribuição de pontuação ainda calibra muitos padrões de recall_min_scores depois que você o deixa. |
BAAI/bge-base-en-v1.5 |
109M | 768 | 512 | ~400 MB | CPU | BGE inglês de médio porte; trava um banco de 768 dim. |
sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2 |
~118M | 384 | 512 | ~200 MB | CPU | MiniLM multilíngue documentado pelo Hindsight; 50+ idiomas na mesma largura de banco de 384 dim que BGE-small. |
intfloat/multilingual-e5-small |
~118M | 384 | 512 | ~200 MB | CPU | Padrão para o provedor onnx; caminho CPU multilíngue leve quando você tem uma exportação ONNX. |
nomic-ai/nomic-embed-text-v1.5 |
~137M | 768 | 8k | ~500 MB | CPU | Embutidor comum do Ollama; contexto mais longo que o BGE clássico, ainda inglês em primeiro lugar. |
google/embeddinggemma-2 |
270M | 768 | 8k | ~540 MB | CPU | EmbeddingGemma 2 apenas texto (desative torres de visão/áudio). 100+ idiomas + código; MRL trunca para 512/256/128; prefixos de instrução para busca vs documento. Carga multimodal completa é 740M. |
BAAI/bge-m3 |
568M | 1024 | 8k | ~1,1 GB | CPU ou GPU | Codificador duplo multilíngue forte; mesma largura que Qwen3-0.6B, então uma troca de mesma dim ainda precisa de um re-embed completo. |
Qwen/Qwen3-Embedding-0.6B |
0.6B | 1024 | 32k | ~1,2 GB | CPU | Padrão deste guia. Consciente de instrução (instrução de busca no lado da consulta); confortável em CPU. O provedor local aplica automaticamente a instrução; servidores compatíveis com OpenAI precisam de HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX. |
Qwen/Qwen3-Embedding-4B |
4B | 2560 | 32k | ~8 GB FP16 / ~2,5 GB quant | GPU | Nível de qualidade Qwen3; trava um banco de 2560 dim. Não viável quando a GPU conversacional já está saturada. |
Como o modelo é executado é a outra metade da escolha. Os provedores de embedding do Hindsight, do mais simples ao mais partes móveis:
| Provedor | Como roda | Melhor quando | Notas |
|---|---|---|---|
local |
SentenceTransformers no processo; sem sidecar | Host único do Hindsight, embutidor CPU | Caminho padrão. Defina HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL. Sem llama.cpp, Ollama ou TEI. |
onnx |
ONNX Runtime no processo | CPU mais leve que Torch; você já tem uma exportação ONNX | Precisa de hindsight-api-slim[local-onnx] e HINDSIGHT_API_EMBEDDINGS_ONNX_*. |
openai / tei |
Endpoint externo compatível com OpenAI ou HF TEI | Embeddings fora do processo de API; host GPU/CPU compartilhado | O que Servir e Conectar Modelos Locais configura para Ollama / llama.cpp / TEI. Só vale o sidecar se você quiser isolamento ou uma máquina diferente. |
O Qwen3-Embedding-0.6B não precisa de um serviço de embeddings externo. Em um host CPU do Hindsight, ele carrega dentro do processo de API com o provedor local — o Hugging Face baixa os pesos na primeira inicialização, e o provedor aplica a instrução de busca do modelo ele mesmo:
# Ambiente Compose (ou chaves .env equivalentes)
HINDSIGHT_API_EMBEDDINGS_PROVIDER: local
HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL: Qwen/Qwen3-Embedding-0.6B
Use um endpoint externo compatível com OpenAI apenas quando você quiser o embutidor em outra máquina ou fora do processo de API. O Ollama é um desses hosts:
# Embeddings: Qwen3-Embedding-0.6B no Ollama
HINDSIGHT_API_EMBEDDINGS_PROVIDER: openai
HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL: http://192.168.1.123:11434/v1
HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL: qwen3-embedding:0.6b-q8_0
HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY: dummy
Substitua o host, porta e tag pelo que ollama list mostrar na sua máquina de inferência.
HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX depende do provedor:
| Caminho | HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX |
HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX |
|---|---|---|
local (Qwen/Qwen3-Embedding-0.6B) |
Deixe não definido / vazio — o provedor no processo aplica a instrução de busca do Qwen ele mesmo | Deixe não definido / vazio |
| Ollama / llama.cpp / compatível com OpenAI externo | Instrução de recuperação oficial do Qwen3 (nova linha real antes de Query:) |
Deixe vazio — as memórias armazenadas permanecem texto bruto |
| Servidor já envolve inputs no template do Qwen | Deixe ambos vazios — caso contrário a instrução é aplicada duas vezes | Deixe vazio |
Para o caminho externo, defina:
# Nova linha real antes de Query:. Bash $'...' é a maneira confiável de passar.
HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=
No YAML do Compose, a mesma string precisa de um \n explícito (ou um valor multilinha literal). Defina os prefixos antes do primeiro retain: mudá-los depois significa que vetores antigos e consultas novas não estão mais no mesmo espaço.
Duas propriedades decidem mais do que a posição no placar de classificação. Sensibilidade à instrução: embeddings do Qwen3 aplicam uma instrução de busca no lado da consulta; sem o prefixo correspondente em um servidor compatível com OpenAI, o lado armazenado e o lado da consulta param de estar no mesmo espaço. Trava de dimensão: porque a largura é lida uma vez na inicialização, mover de 0.6B para 4B depois é uma migração de banco, não uma mudança de configuração — e mesmo uma troca de mesma dimensão (BGE-M3 ↔ Qwen3-0.6B, ou EmbeddingGemma 2 ↔ nomic em 768) muda o espaço vetorial, então os vetores do banco não são recalculados automaticamente. Planeje um banco novo ou um re-embed/reindex manual; veja Exportar, importar e migrar o banco de memória. Após deixar o BGE-small, probe recall_min_scores contra a nova distribuição de pontuação — limiares calibrados no BGE-small podem ser apertados demais para o Qwen3-0.6B e esfriam o reordenador de candidatos. Para benchmarks e informações de fundo sobre GGUF/Ollama da família Qwen3, veja Modelos de Embedding e Reranker Qwen3 no Ollama.
Modelos de Reranking
Embeddings recuperam um conjunto de candidatos; o reordenador pontua cada par consulta/passagem e o reordena antes que o Hindsight injete. Com o provedor local, o Hindsight carrega um cross-encoder do SentenceTransformers (ou um reordenador gerativo onde suportado). Com um endpoint externo compatível com Cohere, ele posta o corpo completo estilo Cohere para HINDSIGHT_API_RERANKER_COHERE_BASE_URL. O reordenador é opcional, mas uma vez que o embutidor é fixo, é geralmente o maior alavancador de qualidade de recall — e, em CPU, frequentemente a maior parte do tempo real de recall. As linhas são ordenadas da mais leve à mais pesada.
| Modelo | Parâmetros | Tipo | Contexto | Roda em | Notas |
|---|---|---|---|---|---|
cross-encoder/ms-marco-MiniLM-L-6-v2 |
23M | Cross-encoder | 128 | CPU | Padrão do Hindsight; vem no hindsight:latest. Sub-segundo para ~20 candidatos. Mantenha como fallback nomeado se um modelo BGE mais pesado for lento demais. |
cross-encoder/ms-marco-MiniLM-L-12-v2 |
~33M | Cross-encoder | 512 | CPU | Mesma família, precisão mais alta; ainda MS MARCO tendente ao inglês. |
cross-encoder/mmarco-mMiniLMv2-L12-H384-v1 |
~33M | Cross-encoder | 512 | CPU | Reordenador MiniLM multilíngue documentado pelo Hindsight. |
BAAI/bge-reranker-base |
278M | Cross-encoder | 512 | CPU | Atualização moderada sobre MiniLM; en/zh. Discutido frequentemente; pulado quando v2-m3 já cabe no orçamento de latência. |
BAAI/bge-reranker-v2-m3 |
568M | Cross-encoder | 8k | CPU ou GPU | Padrão multilíngue prático em CPU. Em um banco de ~500 memórias, ~2,6–2,8 s por recall num piso de 20 candidatos (~140 ms/candidato; ~93–99% do tempo de recall). Limites de candidatos 20/40/80; baixar o piso de 20 → 10 reduz aproximadamente pela metade o custo de rerank. |
Qwen/Qwen3-Reranker-0.6B |
0.6B | Gerativo (token-sim) | 32k | GPU preferido | Consciente de instrução, contexto longo. Não é um cross-encoder drop-in: precisa de suporte recente ao generative-reranker do SentenceTransformers, e o scoring /rerank do llama.cpp tem bugs conhecidos de pontuação incorreta (hindsight-benchmarks#11). Valide antes de adotar. |
BAAI/bge-reranker-v2-gemma |
2.5B | Cross-encoder | 8k | GPU preferido | Qualidade multilíngue forte; excessivo para um banco pessoal de algumas centenas de memórias quando a GPU já está cheia. |
Qwen/Qwen3-Reranker-4B |
4B | Gerativo | 32k | GPU | Candidato Qwen de qualidade mais alta; não viável sem VRAM dedicada. |
Qwen/Qwen3-Reranker-8B |
8B | Gerativo | 32k | GPU | Topo da família; mesmos cuidados de scoring gerativo, maior ainda. |
Reordenadores de API em nuvem (Cohere, ZeroEntropy, Alibaba qwen3-rerank, TypeSafe e semelhantes) funcionam no Hindsight, mas enviam texto de memória para fora da caixa. Para um layout local-only entre domínios, estão fora do escopo.
Duas restrições operacionais dominam a escolha. VRAM: se o modelo conversacional já satura a GPU (por exemplo, um Qwen3.8-27B Q5 em um cartão de 16 GB sem folga), toda linha “GPU preferido” está fora da mesa e a escolha ao vivo colapsa para MiniLM ou BGE-v2-m3 em CPU. Contagem de candidatos: HINDSIGHT_API_RERANKER_MAX_CANDIDATES (30 no exemplo de endpoint externo abaixo) limita quantas passagens o modelo re-pontua; cada candidato é uma passagem completa em frente, então corte o piso antes de saltar um nível de modelo. Para Qwen3 via llama.cpp, o GGUF deve manter o cabeçalho de ranking — um convert_hf_to_gguf.py antigo que o solta pontua todas as passagens perto de zero — e mesmo uma conversão correta ainda precisa de um teste de passagem conhecida-bom/conhecida-ruim até que o caminho de scoring gerativo seja confirmado.
Níveis de LLM Gerativo
Modelos de embedding e reranking não são substitutos para o LLM gerativo usado para extrair e raciocinar sobre memórias. O Hindsight suporta um LLM padrão e sobrescritas específicas por operação, que podem visar o mesmo servidor llama.cpp ou endpoints independentes.
| Operação do Hindsight | Propósito | Nível de modelo prático | Exemplos Qwen |
|---|---|---|---|
| Retain | Extrair fatos, entidades, decisões e cronologia | Mínimo 4B para testes; 9B preferido | Qwen3.5-4B / Qwen3.5-9B |
| Recall | Recuperação semântica, por palavra-chave, grafo e temporal | Nenhum LLM gerativo necessário | Qwen3-Embedding-0.6B + reordenador |
| Reflect | Responder perguntas sintetizando memórias recuperadas | 9B a 27B+ | Qwen3.5-9B / Qwen3.8-27B |
| Consolidação | Conciliar e comprimir fatos relacionados | 9B preferido | Qwen3.5-9B / Qwen3.8-27B |
| Atualização do modelo mental | Atualizar compreensão sintetizada de vida mais longa | 9B a 35B | Qwen3.5-9B / Qwen3.6-35B-A3B |
Essas são recomendações operacionais, não contagens oficiais mínimas de parâmetros do Hindsight. Um modelo pequeno pode extrair um número de porta corretamente, mas perder que uma decisão arquitetônica anterior foi suplantada. A confiabilidade de saída estruturada e o tratamento fiel de negação importam mais do que apenas a contagem nominal de parâmetros. Os padrões próprios de temperatura do Hindsight valem a pena serem deixados sozinhos — 0.1 para retain, 0.0 para consolidação, 0.9 para reflect — e para retain e consolidação, o alias não-pensante vale a pena ser servido se sua build do llama.cpp tiver um, porque os checkpoints pequenos do Qwen3.5 gastam muitos tokens no modo de pensamento.
Para uma implantação com um endpoint llama.cpp existente do Qwen3.8-27B, comece compartilhando-o entre tarefas gerativas do Hindsight com baixa concorrência:
HINDSIGHT_API_LLM_PROVIDER=openai
HINDSIGHT_API_LLM_BASE_URL=http://IP_ESTACAO_DE_TRABALHO:8080/v1
HINDSIGHT_API_LLM_MODEL=LocalMegaLLM
HINDSIGHT_API_LLM_API_KEY=dummy
HINDSIGHT_API_LLM_MAX_CONCURRENT=2
HINDSIGHT_API_RETAIN_LLM_MAX_CONCURRENT=1
HINDSIGHT_API_CONSOLIDATION_LLM_MAX_CONCURRENT=1
Mais tarde, roteie extração de rotina para um modelo 9B independente e reserve o 27B para reflexão difícil:
HINDSIGHT_API_RETAIN_LLM_PROVIDER=openai
HINDSIGHT_API_RETAIN_LLM_BASE_URL=http://HOST_LLM_MEMORIA:8083/v1
HINDSIGHT_API_RETAIN_LLM_MODEL=MemoryLLM
HINDSIGHT_API_RETAIN_LLM_API_KEY=dummy

HINDSIGHT_API_REFLECT_LLM_PROVIDER=openai
HINDSIGHT_API_REFLECT_LLM_BASE_URL=http://IP_ESTACAO_DE_TRABALHO:8080/v1
HINDSIGHT_API_REFLECT_LLM_MODEL=LocalMegaLLM
HINDSIGHT_API_REFLECT_LLM_API_KEY=dummy
O modelo menor de 4B é econômico, mas precisa de testes; 9B é um compromisso sensato de qualidade/desempenho. Se retain e consolidação compartilham um modelo pequeno, reduza HINDSIGHT_API_CONSOLIDATION_LLM_BATCH_SIZE para 2 — o lote padrão de 8 é um prompt longo para uma janela de contexto pequena. O Qwen3.6-35B-A3B é atraente para um servidor de inferência separado e bem provisionado (é um modelo de misturas-de-experts com cerca de 3 bilhões de parâmetros ativos, então orçamentos-o como um modelo ativo pequeno), enquanto um modelo denso de 27B geralmente é desnecessário para cada evento de rotina de retain. Limitar a concorrência em segundo plano protege o modelo conversacional do Hermes de picos de manutenção de memória.
Servir e Conectar Modelos Locais
Se as configurações de embedding e reordenador no processo local em Escolher Modelos forem suficientes, você pode pular as seções externas de Ollama e llama.cpp e pular para a configuração — ou deixar o Compose nos padrões local mostrados lá. Endpoints externos importam quando o embutidor ou reordenador deve viver em outro host.
Embeddings externos: Ollama ou llama.cpp
Embeddings externos são para quando você quer o Qwen3-Embedding-0.6B (ou outro modelo) em um host separado. Duas opções práticas são Ollama, que lida com a aquisição e o serviço do modelo com pouca configuração, e llama.cpp, que dá controle preciso sobre quantização GGUF, threads de CPU, colocação de dispositivo e lote. Informações de fundo do modelo e benchmarks para ambos os modelos Qwen3 estão em Modelos de Embedding e Reranker Qwen3 no Ollama.
O Qwen3-Embedding-0.6B retorna vetores de 1024 dimensões, e o Hindsight lê essa largura na inicialização e dimensiona o banco de dados para corresponder. Um banco criado com o modelo BGE de 384 dimensões incluído não pode aceitar este modelo — comece de um banco de dados ou volume vazio, e decida o modelo de embedding antes do primeiro retain. Uma troca de provedor de embeddings depois exige re-embedding dos registros armazenados, mesmo que ambos os modelos usem a mesma dimensionalidade.
Opção 1: Ollama para Qwen3-Embedding-0.6B
Instale o Ollama no host de inferência usando sua documentação oficial de instalação para Linux, então inicie o modelo de embedding:
ollama pull qwen3-embedding:0.6b
ollama serve
Para acesso remoto, configure OLLAMA_HOST=0.0.0.0:11434 do Ollama em seu ambiente de serviço, reinicie o serviço e faça o firewall para a VM do Hindsight — o procedimento é coberto em Acesso remoto ao Ollama. Um daemon vinculado apenas a 127.0.0.1 é invisível para o contêiner do Hindsight. Primeiro verifique o nome do modelo com ollama list, e teste o endpoint padrão de embedding:
curl http://HOST_EMBED:11434/api/embed \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-embedding:0.6b","input":"Uma memória de teste"}'
O provedor de embeddings OpenAI do Hindsight em vez disso chama o endpoint compatível com OpenAI /v1/embeddings do Ollama. Verifique que esse endpoint funciona com sua versão do Ollama antes de configurar o Hindsight. Ollama é direto para embeddings; não assuma que sua API oferece um endpoint de reranking compatível. Para reranking, prefira o caminho local BGE no processo abaixo, ou um endpoint llama.cpp / TEI separado depois de você ter validado as pontuações.
Opção 2: llama.cpp para Qwen3-Embedding-0.6B
Baixe uma conversão Qwen3-Embedding-0.6B GGUF verificada. Use o nome do arquivo GGUF que você realmente baixou:
#!/bin/sh
# start-embedding.sh - servidor de embedding apenas CPU
set -eu
cd "$HOME/prj"
exec ./llama.cpp/llama-server \
  --host 0.0.0.0 --port 8081 \
  --model "$HOME/ggufs/Qwen3-Embedding-0.6B-Q8_0.gguf" \
  --alias qwen3-embedding-0.6b \
  --embedding --pooling last \
  --ctx-size 4096 --parallel 1 \
  --threads 4 --threads-batch 4 \
  --batch-size 512 --ubatch-size 256 \
  --n-gpu-layers 0
Embeddings do Qwen3 usam pooling do último token, ao contrário do pooling CLS usado por alguns modelos BGE. Uma build llama.cpp apenas CPU é preferível se você quiser absolutamente nenhuma inicialização de CUDA em uma estação de trabalho cuja GPU é ocupada por um grande modelo conversacional. Não habilite --reranking neste servidor de embedding: essa combinação é uma maneira conhecida de obter um vetor de zeros.
curl -s http://HOST_EMBED:8081/v1/embeddings \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-embedding-0.6b","input":"Uma memória de teste"}' \
  | jq '.data[0].embedding | length'
Uma saída de dimensão completa do Qwen3-Embedding-0.6B deve conter 1024 flutuantes. Verifique que a conversão GGUF e seu tratamento de instrução de consulta/documento do Hindsight são compatíveis; modelos de embedding sensíveis à instrução podem perder precisão quando solicitados incorretamente.
Reordenador: BGE local ou Qwen3 via llama.cpp
Reranking é diferente de embeddings: o modelo pontua cada par documento/consulta e retorna uma pontuação de relevância. Em um host CPU apenas do Hindsight — ou sempre que a GPU conversacional não tem folga de VRAM — o caminho prático é o provedor local do Hindsight com BAAI/bge-reranker-v2-m3 (ou o padrão MiniLM mais leve). Nenhum sidecar é necessário:
HINDSIGHT_API_RERANKER_PROVIDER=local
HINDSIGHT_API_RERANKER_LOCAL_MODEL=BAAI/bge-reranker-v2-m3
HINDSIGHT_API_RERANKER_MAX_CANDIDATES=20
O Qwen3-Reranker-0.6B é um pontuador gerativo de token-sim, não um cross-encoder clássico. Ele pode ser servido através do llama.cpp com uma conversão GGUF projetada para ranking, mas trate esse caminho como experimental até você confirmar pontuações em um par conhecido-bom/conhecido-ruim: um convert_hf_to_gguf.py antigo que solta o cabeçalho de ranking pontua todas as passagens perto de zero, e o caminho nativo /rerank do llama.cpp tem relatórios conhecidos de pontuação incorreta para esta família.
#!/bin/sh
# start-reranker.sh - GPU ou CPU conforme selecionado por --n-gpu-layers
set -eu
cd "$HOME/prj"
exec ./llama.cpp/llama-server \
  --host 0.0.0.0 --port 8082 \
  --model "$HOME/ggufs/Qwen3-Reranker-0.6B-Q8_0.gguf" \
  --alias qwen3-reranker-0.6b \
  --embedding --reranking --pooling rank \
  --ctx-size 4096 --parallel 1 \
  --batch-size 512 --ubatch-size 256 \
  --n-gpu-layers 99
Defina --n-gpu-layers 0 para executá-lo em CPU. A versão GPU precisa de VRAM adicional para buffers de cálculo e contexto, não apenas pesos do modelo; evite assumir que o tamanho do arquivo é a alocação total de GPU.
curl -s http://HOST_RERANK:8082/v1/rerank \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-reranker-0.6b", "query":"armazenamento PostgreSQL", "documents":["Hindsight armazena memórias no PostgreSQL.","Uma receita de pão."], "top_n":2}' \
  | jq
O documento PostgreSQL deve classificar acima do documento não relacionado; pontuações de relevância todas a zero significam que o GGUF é a conversão errada, e o recall parecerá aleatório mesmo quando os fatos estão armazenados. Verifique a forma exata de results[].index e results[].relevance_score: o Hindsight espera uma resposta de rerank compatível com Cohere, e a compatibilidade do llama.cpp pode variar entre builds.
Conectar endpoints ao Hindsight
Adicione as seguintes configurações de ambiente ao serviço Compose do Hindsight, ou armazene-as em seu arquivo .env. Escolha um caminho de embeddings — local no processo, Ollama ou llama.cpp — nunca dois ao mesmo tempo.
# Opção A: Qwen3 no processo no host do Hindsight (CPU; sem sidecar)
HINDSIGHT_API_EMBEDDINGS_PROVIDER=local
HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL=Qwen/Qwen3-Embedding-0.6B

# Opção B: serviço de embedding llama.cpp
# HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL=http://HOST_EMBED:8081/v1
# HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL=qwen3-embedding-0.6b
# HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY=dummy
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BATCH_SIZE=8
# HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
# HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=

# Opção C: Ollama em outro host
# HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL=http://192.168.1.40:11434/v1
# HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL=qwen3-embedding:0.6b-q8_0
# HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY=dummy
# HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
# HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=

# Opção: reordenador BGE local (sem sidecar; preferido em CPU)
HINDSIGHT_API_RERANKER_PROVIDER=local
HINDSIGHT_API_RERANKER_LOCAL_MODEL=BAAI/bge-reranker-v2-m3
HINDSIGHT_API_RERANKER_MAX_CANDIDATES=20

# Opção: endpoint de rerank compatível com Cohere llama.cpp (valide pontuações Qwen3 primeiro)
# HINDSIGHT_API_RERANKER_PROVIDER=cohere
# HINDSIGHT_API_RERANKER_COHERE_BASE_URL=http://HOST_RERANK:8082/v1/rerank
# HINDSIGHT_API_RERANKER_COHERE_MODEL=qwen3-reranker-0.6b
# HINDSIGHT_API_RERANKER_COHERE_API_KEY=dummy
# HINDSIGHT_API_RERANKER_MAX_CANDIDATES=30
Os nomes das variáveis são específicos do provedor, e um erro quase certo é silencioso: HINDSIGHT_API_EMBEDDINGS_BASE_URL é a chave errada, e o Hindsight visa silenciosamente o próprio endpoint de embedding da OpenAI em vez do seu servidor local. Use HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL. Com o caminho de reordenador compatível com Cohere, o Hindsight posta o corpo completo estilo Cohere para HINDSIGHT_API_RERANKER_COHERE_BASE_URL; se o log do contêiner mostra um 404 para /v1/rerank/rerank, sua build anexa /rerank por conta própria e o valor deve parar em /v1.
Para as Opções B e C, use o valor de HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX de Modelos de Embedding (a Opção A deixa-o não definido). Teste a recuperação de consulta para passagem em suas memórias reais após o primeiro retain.
Controlar o que é lembrado
Com a pilha em execução, o próximo modo de falha é geralmente o caminho de escrita: o Hermes padrão é auto_retain: true, então cada turno de conversa pode ser extraído para o banco. Palpites incorretos, planos descartados e declarações exploratórias tornam-se fatos pesquisáveis, e recall posterior os trata como evidência — o laço descrito em laços de memória auto-reforçados. A política de captura para Hindsight entre outros provedores é resumida em provedores de memória para agentes comparados.
Modos de captura que existem hoje
| Modo | Configurações Hermes / Hindsight | O que você obtém |
|---|---|---|
| Contínuo | auto_retain: true, retain_every_n_turns: 1 |
Cada turno é retido e extraído |
| Auto em lote | auto_retain: true, aumente retain_every_n_turns |
Menos, mas maiores cargas de retain — ainda automático, não uma fila de revisão |
| Apenas explícito | auto_retain: false + ferramenta hindsight_retain |
Armazenamento apenas quando o agente chama a ferramenta (por exemplo, depois que você diz “lembre-se disso”) |
| Síntese de sessão | hindsight_retain de fim de sessão de um resumo, ou reflect / consolidação do banco |
Uma escrita curada se você ou o agente disciplinam a chamada — não um flush para aprovação embutido |
Definir auto_retain como false desativa o armazenamento automático. Isso não adiciona um diálogo de aprovação humana antes de cada escrita. O agente ainda pode chamar hindsight_retain sempre que suas ferramentas permitirem; trate retain explícito como captura deliberada, não uma fila pendente.
A lacuna da fila de aprovação
Um desejo comum é uma fila pendente de memórias candidatas que você revise e aprove antes que entrem no banco. O Hindsight sob o Hermes não fornece esse contrato hoje. Mnemosyne para Hermes implementa escritas em etapas específicas do provedor em algumas versões; esse caminho não é um padrão compartilhado do Hermes e não se aplica ao plugin do Hindsight. Até que um fluxo de aprovação de origem exista, o padrão viável é auto_retain: false, hindsight_retain deliberado e inspeção ou exclusão na UI de plano de controle do Hindsight antes que a próxima sessão confie em um fato ruim. Não há uma chave write_approval faltando para o Hindsight procurar no config.json.
Direcionamento do banco (missões, rótulos, diretivas, modelos mentais)
As pessoas frequentemente chamam a próxima camada de “fine-tuning”. No Hindsight, é em grande parte configuração do banco, não apenas config.json do Hermes: missões e configurações de extração dirigem o que retain mantém; rótulos estruturam entidades; diretivas e modelos mentais moldam a síntese posterior.
| Controle | Onde vive | Como ajuda |
|---|---|---|
Missão de retain (retain_mission / Hermes bank_retain_mission) |
Configuração do banco | “Preste atenção em X, ignore Y” em linguagem simples injetado na extração |
Modo de extração (concise, verbose, custom, …) |
Configuração do banco | concise (padrão) mantém fatos dignos de longo prazo; custom substitui regras embutidas via retain_custom_instructions |
| Rótulos de entidade | Configuração do banco | Vocabulário controlado chave:valor no momento do retain → links de grafo e tags opcionais; melhora a estrutura de recuperação, não rejeita sozinha declarações erradas |
| Diretivas (“regras duras”) | API de diretivas do banco | Instruções explícitas aplicadas durante reflect (escopo de tag); restringe a síntese, não é uma porta de aprovação de escrita |
| Modelos mentais | API de modelo mental do banco | Respostas constantes a perguntas recorrentes, atualizadas via reflect de memórias correspondentes; derivadas, então fatos de origem ruins ainda as envenenam |
| Missão de reflect / observações | Configuração do banco | Direciona síntese e consolidação, não o jato de retain bruto |
Missões, extração concisa e rótulos reduzem o ruído e melhoram a recuperação. Eles não substituem desligar o auto-retain quando a precisão importa mais do que a completude. Prefira uma missão de retain curta que nomeie decisões duráveis de projeto e ignore logística de chat; adicione rótulos de entidade apenas quando você tiver uma taxonomia real; adicione modelos mentais para duas ou três perguntas recorrentes depois que o banco já mantém fatos limpos.
Perfil de higiene recomendado
Um ponto de partida concreto para um banco pessoal do Hermes:
{
  "mode": "local_external",
  "api_url": "http://IP_VM_HINDSIGHT:8888",
  "bank_id": "hermes",
  "memory_mode": "hybrid",
  "auto_recall": true,
  "recall_sync": false,
  "auto_retain": false,
  "retain_async": true,
  "recall_prefetch_method": "recall"
}
No banco, defina uma missão de retain e deixe a extração no modo concise (via plano de controle ou API de Bancos). Após um retain explícito, abra a UI, confirme a observação e exclua erros antes que a consolidação ou atualização do modelo mental rode. Deixe recall_prefetch_method em recall — reflect gasta uma chamada de modelo de chat antes de cada turno e injeta síntese em vez de fatos subjacentes.
Conectar Agente Hermes ao Hindsight
Na VM do Hermes, instale o plugin do catálogo, então execute o assistente de configuração. Selecione Hindsight e o modo local_external; o plugin não precisa iniciar o PostgreSQL embutido ou executar a pilha de modelos do Hindsight localmente, e local_embedded iniciaria um segundo daemon do Hindsight ao lado do contêiner que você acabou de executar.
hermes plugins install hindsight
hermes memory setup hindsight
Haverá um conjunto interessante de opções de papel do agente usando hindsight
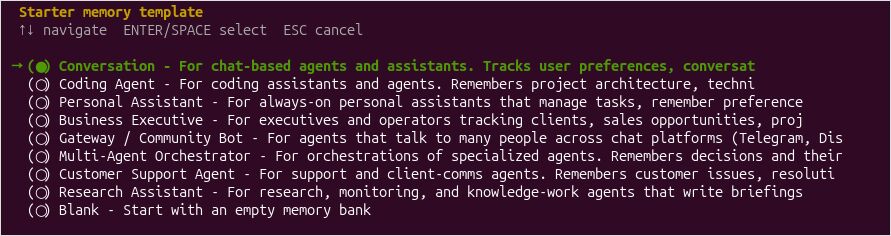
hermes memory status
A conexão externa do Hindsight vive em ~/.hermes/hindsight/config.json. Uma configuração ilustrativa que mantém captura contínua (padrões do Hermes) é:
{
  "mode": "local_external",
  "api_url": "http://IP_VM_HINDSIGHT:8888",
  "bank_id": "hermes",
  "memory_mode": "hybrid",
  "auto_recall": true,
  "recall_sync": false,
  "auto_retain": true,
  "retain_async": true,
  "retain_every_n_turns": 1
}
Para retain apenas explícito e direcionamento do banco, use o perfil de higiene em Controlar o que é lembrado em vez de deixar auto_retain ligado. recall_sync: false prioriza a responsividade interativa, mas pode injetar contexto recuperado no turno seguinte. Use recall síncrono quando a solicitação atual deve incorporar as memórias mais recentes antes que o modelo comece a responder. retain_async: true evita bloquear respostas normais enquanto as memórias são processadas.
O padrão de recall do plugin é apenas observações; fatos brutos do mundo e de experiência permanecem no banco e fora do prompt até que a consolidação tenha escrito uma observação, ou até que você amplie recall_types para observation,world,experience. Ampliá-lo na primeira semana e observando o plano de controle, e depois estreitando, é uma ordem razoável.
A memória embutida do Hermes permanece ativa ao lado do provedor; manter MEMORY.md e USER.md ligados enquanto você aprende o que o Hindsight adiciona está bem, e o artigo do sistema de memória é o lugar para decidir se os arquivos planos devem permanecer.
Reinicie o gateway se ele já estiver em execução:
hermes gateway restart
hermes memory status
O status deve identificar o Hindsight como o provedor ativo. Para uma referência de comandos mais ampla, incluindo o TUI do Hermes e comandos de plugin, veja a folha de dicas do CLI do Hermes Agent.
Validar Memória, Não Apenas Instalação
Pergunte ao Hermes para lembrar um fato descartável sobre um projeto de teste, inicie outra sessão e pergunte por esse fato novamente. A retenção é assíncrona por padrão e a extração espera pelo modelo de chat, então dê um momento ao servidor llama.cpp principal antes de julgar. Depois teste um caso mais difícil: diga ao Hermes que uma decisão anterior mudou e pergunte qual decisão é atual e por quê. Verifique a UI do Hindsight e as observações armazenadas em vez de assumir que memory status prova que ingestão e recall estão corretos.
Se a resposta voltar vazia, inspecione o plano de controle antes de mudar modelos. Um retain pode ter sucesso e ainda assim ser invisível para o recall enquanto recall_types é apenas observações e a consolidação não rodou — ampliar recall_types é a primeira verificação. Uma conexão recusada no log do servidor de embedding significa que o contêiner não pode alcançar a porta de embedding, e pontuações de reordenador todas a zero significam que o GGUF é a conversão errada.
Escolhas de caminho de escrita (auto_retain, missões, lacuna de aprovação) são cobertas em Controlar o que é lembrado.
Solução de Problemas e Notas Operacionais
| Sintoma | Provável causa | Primeira verificação |
|---|---|---|
| Hermes diz provedor indisponível | URL local_external errada ou regra de rede |
curl http://IP_VM_HINDSIGHT:8888/health |
| Docker inicia, erros no PostgreSQL | Extensão em falta, credenciais erradas ou memória compartilhada insuficiente | Logs do contêiner e pg_extension |
| Embeddings retornam 401 ou 404 | URL compatível com OpenAI incorreta, nome de chave de ambiente errado ou desajuste de alias do modelo | Teste direto /v1/embeddings e nomes de variáveis |
| Reranking falha | Desajuste de endpoint ou formato de resposta, incluindo caminho /rerank duplicado |
Teste direto /v1/rerank e log do contêiner |
| Recall não retorna nada utilizável | recall_types limitado a observações, ou pontuações de reordenador zero |
Plano de controle, então recall_types, então conversão do reordenador |
| Banco existente relata desajuste de dimensão | Modelo de embedding mudou | Reconstruir vetores/reimportar com um modelo consistente |
| Respostas do Hermes ficam lentas | Recall síncrono ou disputa de LLM compartilhado | Desligar recall síncrono; limitar concorrência de retain |
| Memórias irrelevantes se repetem | Extração fraca, recuperação ruidosa ou consolidação insuficiente | Inspecionar observações e pontuações de relevância |
Uma pequena implantação prática é 2-4 vCPUs e 4-6 GB de RAM para a VM da API do Hindsight quando PostgreSQL e toda inferência são externos. A alocação de disco ainda depende da imagem Docker escolhida e das camadas de imagem retidas; aloque aproximadamente 30-40 GB inicialmente com espaço para expandir. Dimensione o host PostgreSQL com base no volume de memória real, desempenho de armazenamento e outros bancos de dados que ele serve.
Fazer backup e restaurar o banco do Hindsight
O banco de memória é o único estado que importa, e ele vive no PostgreSQL. Na Opção B, é um banco de dados que você administra; na Opção A, é o volume nomeado pg0 embutido dentro do contêiner. Faça backup dele independentemente do contêiner do Hindsight — recriar o contêiner sem primeiro capturar o volume ou o banco de dados descarta o banco, e hermes backup não alcança um banco executado em um serviço separado.
Opção B — PostgreSQL externo. Faça o despejo do banco de dados hindsight em formato personalizado, então restaure-o em um banco de dados de rascunho para verificar o arquivo antes de você confiar nele:
pg_dump -h IP_POSTGRES -U hindsight -Fc hindsight > hindsight-bank.dump

# restaure em um banco de dados de rascunho para provar que o despejo é utilizável
createdb -h IP_POSTGRES -U postgres hindsight-verify
pg_restore -h IP_POSTGRES -U postgres -d hindsight-verify hindsight-bank.dump
Confirme que a extensão pgvector e um recall de amostra existem na cópia restaurada antes de você excluir o destino do despejo original. Mantenha o despejo em um host diferente da VM do Hindsight, e execute isto como um administrador do PostgreSQL (um papel que pode criar bancos de dados) em vez do papel da aplicação.
Opção A — contêiner tudo-em-um. O banco de dados embutido é um volume nomeado, então pare o contêiner e faça o tar do volume através de uma imagem descartável:
docker stop hindsight
docker run --rm -v hindsight-pg0:/data -v "$PWD":/backup alpine \
  tar czf /backup/hindsight-bank.tgz -C /data .
docker start hindsight
O ponto de montagem dentro do contêiner tar (/data) é arbitrário; ele simplesmente alisa o volume nomeado para que tar possa lê-lo. Para restaurar, pare o contêiner, limpe o volume e desfaça o tar do arquivo de volta nele, ou aponte o contêiner para a restauração do PostgreSQL externo da Opção B.
Tire um instantâneo em três momentos em vez de em uma agenda de calendário: antes de mudar o modelo de embedding, antes de uma atualização importante do Hindsight ou PostgreSQL, e antes de uma passagem de reflect ou consolidação que reescreve o banco. Um backup que você restaurou em um banco de rascunho vale mais do que um que você apenas escreveu.
Exportar, importar e migrar o banco de memória
Backup e restauração protegem o banco no lugar. Exportar/importar move-o entre instâncias do Hindsight, e é isso que uma mudança de modelo na verdade o obriga a fazer.
Mudar o modelo de embedding não é uma edição de configuração. Os vetores no banco foram calculados com o modelo antigo, e um modelo diferente — por exemplo, o embutidor BGE de 384 dimensões incluído versus o Qwen3-Embedding-0.6B de 1024 dimensões — escreve em um espaço diferente e geralmente uma largura diferente. Você não pode redirecionar a instância existente para o novo embutidor e manter os vetores antigos; as dimensões devem ser recalculadas re-embedando cada memória com o novo modelo de embedding.
Como o embutidor e sua configuração são definidos por instância do Hindsight, o caminho limpo é estabelecer uma nova instância com a nova configuração de embedding e migrar o banco para ela, em vez de reconstruir vetores dentro da que já está servindo recall. A API do Hindsight também pode mover o banco, mas para uma mudança única, exportar/importar é o caminho mais fácil e inspecionável:
# exportar o banco da instância antiga
docker exec hindsight \
  hindsight-admin export-bank \
    --bank hermes2 \
    --output /tmp/hermes2.zip

docker cp hindsight:/tmp/hermes2.zip ./hermes2.zip

ls -lh hermes2.zip
unzip -t hermes2.zip

# importar o banco para a nova instância
docker cp ./hermes2.zip hindsight-q06:/tmp/hermes2.zip

docker exec hindsight-q06 \
  hindsight-admin import-bank \
    --archive /tmp/hermes2.zip
unzip -t verifica o arquivo antes de você enviá-lo para a nova instância. Após a importação, redirecione o Hermes para a api_url da nova instância em ~/.hermes/hindsight/config.json, reinicie o gateway e execute a validação de memória de antes: um fato retido deve recuperar através do novo embutidor. Deixe o banco antigo e seus vetores na instância antiga até que a nova funcione, então você ainda tem um fallback funcionando.
Monitorar, podar e manter o banco estável
Com o banco em execução, o trabalho diário é observar o que o modelo de extração decidiu armazenar e manter o estado derivado sob controle. Use a UI do plano de controle (hindsight-embed -p hermes ui start) para inspecionar observações, pontuações de relevância e saída de consolidação em vez de assumir que memory status prova que ingestão e recall estão corretos. Memórias duplicadas ou desatualizadas são geralmente uma extração fraca ou uma consolidação subexecutada, então corrija o nível de extração ou a cadência de consolidação antes de ampliar a recuperação.
Duas armadilhas de manutenção valem a pena serem testadas antes de você confiar no banco. Primeiro, excluir uma observação não garante que todas as representações derivadas desapareçam com ela — um fato reflect ou aresta de grafo construída a partir dela pode sobreviver à exclusão, então verifique a exclusão de ponta a ponta, a mesma preocupação de proveniência coberta em laços de memória auto-reforçados. Segundo, mantenha HINDSIGHT_API_WORKER_ID estável entre recriações e fixe uma tag de imagem específica: uma tarefa que estava em andamento quando o contêiner morreu permanece travada sob o antigo id do trabalhador, e uma tag móvel é uma correspondência ruim para um banco de dados que você pretende manter.
