
El auge y la caída de OpenClaw: cronología y las razones reales detrás del colapso
OpenClaw creció rápidamente. Luego desapareció más rápido.
OpenClaw no fracasó como producto. Perdió su combustible.
OpenClaw creció rápidamente. Luego desapareció más rápido.
OpenClaw no fracasó como producto. Perdió su combustible.
Sirva e intercambie LLMs sin reinicios.
Durante mucho tiempo, llama.cpp tuvo una limitación flagrante:
solo se podía servir un modelo por proceso, y cambiar de modelo implicaba un reinicio.
Herramientas, métodos y wikis autohospedados de PKM comparados.
La gestión del conocimiento personal abarca Obsidian, Logseq, DokuWiki, Zettelkasten y PARA: la elección correcta depende de si deseas un grafo de notas local, una wiki autoalojada o un flujo de trabajo basado en un outliner.
Configuraciones de Hermes con prioridad en el perfil para cargas de trabajo serias
El asistente de IA Hermes, documentado oficialmente como Hermes Agent, no está posicionado como un simple envoltorio de chat.
Las habilidades que valen la pena conservar y las que hay que omitir
OpenClaw tiene dos historias de extensiones y es fácil confundirlas.
Los complementos (plugins) amplían el tiempo de ejecución. Las habilidades (skills) amplían el comportamiento del agente.
Primero los complementos. Breve denominación de las habilidades.
Este artículo trata sobre los plugins de OpenClaw: paquetes de puerta de enlace nativa que añaden canales, proveedores de modelos, herramientas, voz, memoria, medios, búsqueda web y otras superficies de tiempo de ejecución.
Cómo están realmente estructurados los sistemas OpenClaw
OpenClaw parece simple en las demostraciones. En producción, se convierte en un sistema.

Búsqueda de IA autoalojada con LLMs locales
Vane es una de las entradas más pragmáticas en el espacio de “búsqueda de IA con citas”: un motor de respuestas autoalojado que combina la recuperación en tiempo real de la web con LLMs locales o en la nube, manteniendo toda la pila bajo tu control.
Instalación y guía rápida de Hermes Agent para desarrolladores
Hermes Agent es un asistente de IA autoalojado, agnóstico de modelos, que se ejecuta en una máquina local o en un VPS de bajo coste, funciona a través de interfaces de terminal y mensajería, y mejora con el tiempo al convertir tareas repetidas en habilidades reutilizables.
Instala TGI, despliega rápido, depura más rápido.
Text Generation Inference (TGI) tiene una energía muy específica. No es el último en llegar en la calle de la inferencia, pero es el que ya aprendió cómo se rompen las cosas en producción -
Sirva modelos abiertos rápidamente con SGLang.
SGLang es un marco de servicio de alto rendimiento para grandes modelos de lenguaje y modelos multimodales, diseñado para ofrecer inferencia de baja latencia y alto rendimiento en todo, desde una sola GPU hasta clústeres distribuidos.
Intercambia modelos LLM locales en caliente sin modificar los clientes.
Pronto estarás gestionando vLLM, llama.cpp y más—cada pila en su propio puerto. Todo lo que hay aguas abajo sigue requiriendo una única URL base /v1; de lo contrario, seguirás intercambiando puertos, perfiles y scripts de un solo uso. llama-swap es el proxy /v1 que se sitúa antes de esas pilas.
La mayoría de las configuraciones de IA locales comienzan con un modelo y un entorno de ejecución (runtime).
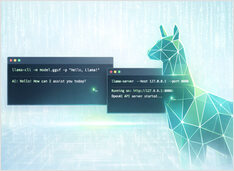
Ejecuta modelos GGUF con la CLI y el servidor
llama.cpp es un motor de inferencia en C/C++ para modelos GGUF: llama-cli para chat interactivo, llama-completion para prompts guiados por guion, y llama-server para una API HTTP compatible con OpenAI.
Guía del Asistente de IA OpenClaw
La mayoría de las configuraciones de IA local comienzan de la misma manera: un modelo, un entorno de ejecución y una interfaz de chat.
Compare headless CMS - características, rendimiento y casos de uso
Elegir el CMS sin cabeza adecuado puede marcar la diferencia en tu estrategia de gestión de contenido. Vamos a comparar tres soluciones de código abierto que influyen en cómo los desarrolladores construyen aplicaciones impulsadas por contenido.