
Open WebUI: Interfaz autoalojada para LLM
Alternativa autoalojada de ChatGPT para LLMs locales
Open WebUI es una potente, extensible y completa interfaz web autoalojada para interactuar con modelos de lenguaje de gran escala.
Alternativa autoalojada de ChatGPT para LLMs locales
Open WebUI es una potente, extensible y completa interfaz web autoalojada para interactuar con modelos de lenguaje de gran escala.
Instala, sirve y ajusta vLLM en 2026
vLLM es un motor de inferencia y servicio de alto rendimiento y eficiente en memoria para Modelos de Lenguaje Grandes (LLMs), desarrollado por el Sky Computing Lab de UC Berkeley.
Reflexiones sobre LLMs para Cognee autohospedado
Elegir el Mejor LLM para Cognee requiere equilibrar la calidad de construcción de gráficos, las tasas de alucinación y las restricciones de hardware. Cognee destaca con modelos grandes de baja alucinación (32B+) a través de Ollama pero las opciones de tamaño medio funcionan para configuraciones más ligeras.
Compare las mejores herramientas de alojamiento local de LLM en 2026. Madurez de la API, soporte de hardware, tool calling y casos de uso reales.
Ejecutar LLMs localmente es ahora práctico para desarrolladores, startups e incluso equipos de empresa. Pero elegir la herramienta adecuada — Ollama, vLLM, LM Studio, LocalAI u otras — depende de tus objetivos:
Configure tamaños de contexto en Docker Model Runner con soluciones alternativas
Configuración de tamaños de contexto en Docker Model Runner es más compleja de lo que debería ser.
Habilite la aceleración de GPU para Docker Model Runner con soporte de NVIDIA CUDA
Docker Model Runner es la herramienta oficial de Docker para ejecutar modelos de IA localmente, pero habilitar la aceleración de GPU de NVidia en Docker Model Runner requiere una configuración específica.
Referencia rápida para comandos de Docker Model Runner
Docker Model Runner (DMR) es la solución oficial de Docker para ejecutar modelos de IA localmente, introducida en abril de 2025. Esta guía rápida proporciona una referencia rápida para todos los comandos esenciales, configuraciones y mejores prácticas.
Compare Docker Model Runner y Ollama para LLM local
Correr modelos de lenguaje grandes (LLMs) localmente ha ganado popularidad cada vez mayor por razones de privacidad, control de costos y capacidades fuera de línea. El paisaje cambió significativamente en abril de 2025 cuando Docker introdujo Docker Model Runner (DMR), su solución oficial para la implementación de modelos de IA.
Integración de Ollama con Go: guía de SDK, ejemplos y mejores prácticas para producción.
Esta guía ofrece una vista general completa de los SDKs de Go para Ollama y compara sus conjuntos de funciones.
+ Ejemplos Específicos Utilizando LLMs de Pensamiento
En este post, exploraremos dos formas de conectar tu aplicación Python a Ollama: 1. A través de HTTP REST API; 2. A través de la biblioteca oficial de Python de Ollama.
Mi perspectiva sobre el estado actual del desarrollo de Ollama
Ollama se ha convertido rápidamente en una de las herramientas más populares para ejecutar LLMs localmente. Su simple CLI y la gestión de modelos simplificada lo han convertido en una opción predilecta para los desarrolladores que desean trabajar con modelos de IA fuera de la nube.
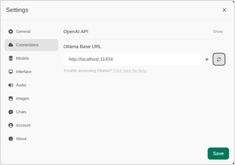
Breve visión general de las interfaces de usuario más destacadas para Ollama en 2025
Locally hosted Ollama permite ejecutar modelos de lenguaje grandes en tu propia máquina, pero usarlo desde la línea de comandos no es muy amigable para el usuario. Aquí hay varios proyectos de código abierto que ofrecen interfaces estilo ChatGPT que se conectan a un Ollama local.
qwen3 8b, 14b y 30b, devstral 24b, mistral small 24b
En este test estoy comparando cómo diferentes LLMs alojados en Ollama traducen una página Hugo en inglés al alemán.
Lista breve de proveedores de LLM
El uso de LLMs no es muy costoso, podría no haber necesidad de comprar una nueva GPU impresionante. Aquí hay una lista si proveedores de LLM en la nube con LLMs que alojan.
Comparando dos modelos deepseek-r1 con dos modelos base
DeepSeek’s primer generación de modelos de razonamiento con un rendimiento comparable al de OpenAI-o1, incluyendo seis modelos densos destilados de DeepSeek-R1 basados en Llama y Qwen.
Lista de comandos actualizada de Ollama - ls, ps, run, serve, etc.
Esta hoja de referencia de la CLI de Ollama se centra en los comandos que utilizas a diario (ollama ls, ollama serve, ollama run, ollama ps, gestión de modelos y flujos de trabajo comunes), con ejemplos que puedes copiar y pegar.