
Роутинг моделей: перестаньте использовать одну модель для всего
Подходящая модель для нужной задачи.
Запуск модели на 70 млрд параметров для суммирования письма из 200 слов — расточительство. А использование модели на 3 млрд параметров для рецензирования продакшен-кода — безрассудство. Большинство систем находится где-то посередине — и именно здесь на помощь приходит маршрутизация моделей.
Она сопоставляет сложность задачи с возможностями модели. Компромиссы реальны, но и экономия тоже.
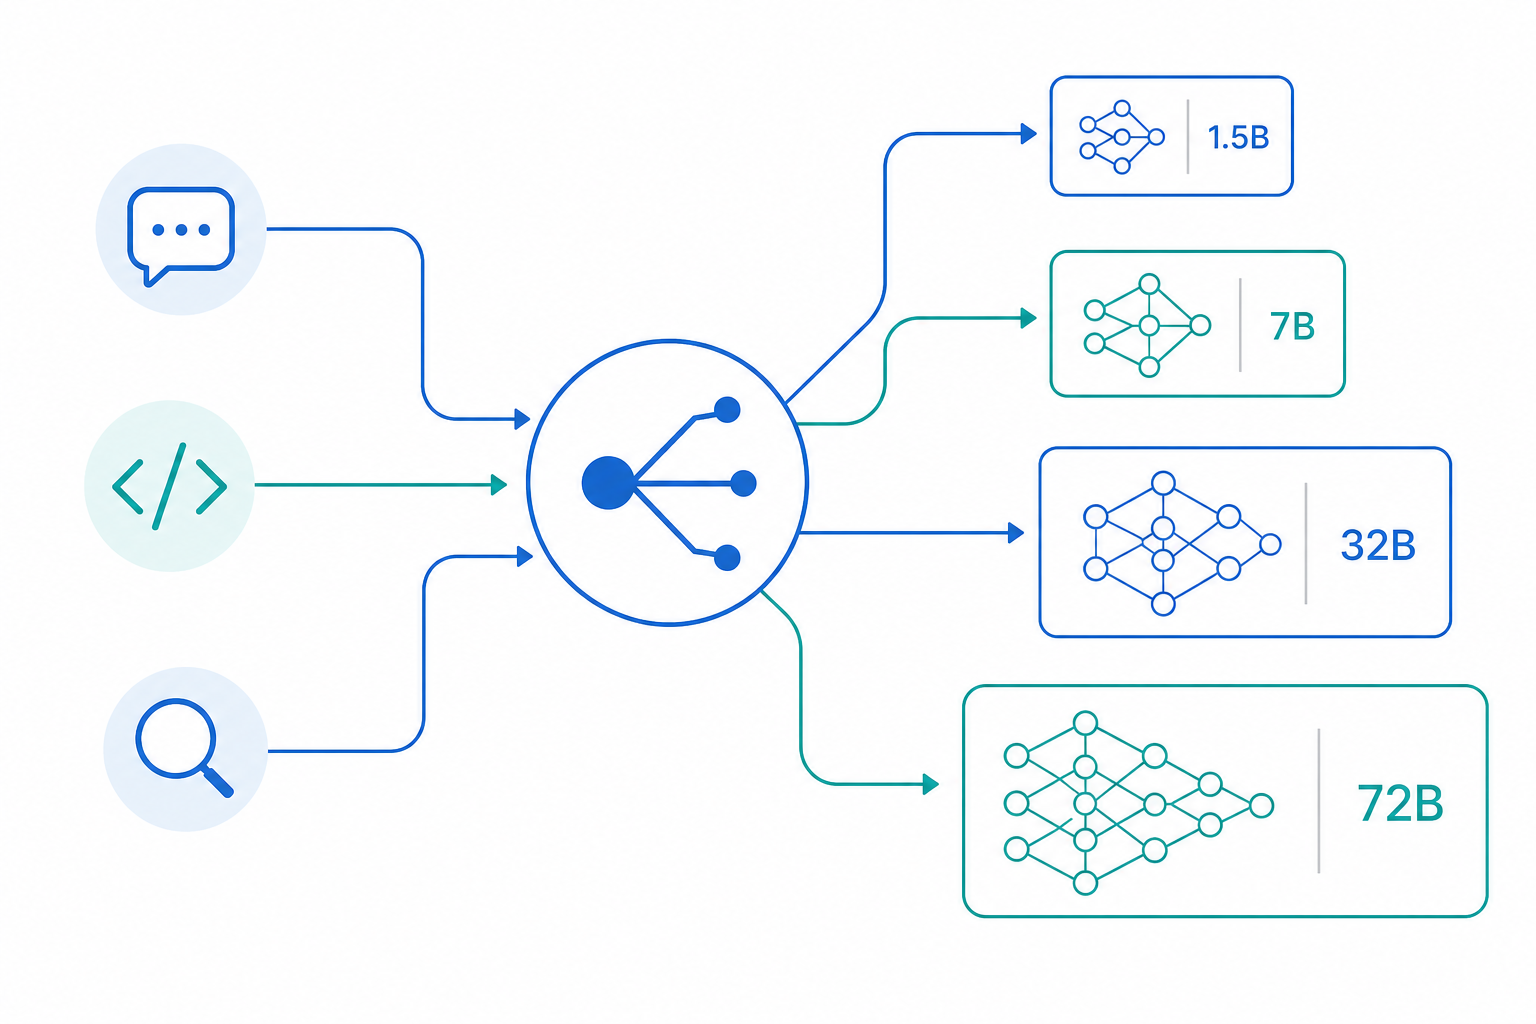
Проблема маршрутизации
Обычно люди начинают с одной модели и придерживаются её. Это работает, пока вы не заметите расходы или задержки (или и то, и другое). Альтернатива — построение маршрутизатора — компонента, который решает, какая модель будет обрабатывать конкретный запрос.
В практике работают четыре стратегии:
- Основанная на возможностях — маршрутизация по тому, что модель умеет делать
- С учётом стоимости — маршрутизация по тому, сколько вы готовы платить
- С учётом задержек — маршрутизация по скорости, которая вам нужна
- Гибридная — комбинация остальных
Каждая оптимизирует что-то своё. Выбор одной обычно сводится к решению о том, что причиняет боль.
Маршрутизация на основе возможностей
Самый простой подход. Классифицируйте задачу и отправляйте её модели, которая умеет с ней справляться.
| Задача | Размер модели | Примеры |
|---|---|---|
| Классификация, тегирование | 1-3B | Qwen3-1.7B, Gemma-2-2B |
| Суммирование, извлечение данных | 3-7B | Qwen3-8B, Llama-3.1-8B |
| Генерация кода | 7-14B | Qwen2.5-Coder-7B, DeepSeek-Coder-V2 |
| Сложные рассуждения | 14-32B | Qwen3-32B, Llama-3.1-70B |
| Творческое письмо, анализ | 32B+ | Qwen2.5-72B, Claude, GPT-4 |
Если задаче не нужна большая модель, не используйте её. Модель на 1.5B хорошо справляется с классификацией тональности. Просто она не напишет связное эссе.
Реализация очевидна:
ROUTING_RULES = {
    "classify": {"model": "qwen3-1.7B", "max_tokens": 100},
    "summarize": {"model": "qwen3-8B", "max_tokens": 500},
    "code_review": {"model": "qwen2.5-coder-7b", "max_tokens": 2000},
    "reason": {"model": "qwen3-32b", "max_tokens": 4000},
    "creative": {"model": "claude-sonnet-4", "max_tokens": 8000},
}

def route_request(task_type: str) -> dict:
    return ROUTING_RULES.get(task_type, ROUTING_RULES["reason"])
Хитрость кроется в самой классификации. Если вы ошибётесь в типе задачи, вы маршрутизируете запрос в неправильную модель. Я видел системы, которые классифицировали рецензию кода как «суммирование» и молча теряли качество.
Маршрутизация с учётом стоимости
Локальный инференс блестит здесь. Локальные модели практически бесплатны после амортизации оборудования. RTX 5080 окупает себя примерно за шесть месяцев при умеренном использовании API.
| Модель | Вход ($/M токенов) | Выход ($/M токенов) | Локальная стоимость/час |
|---|---|---|---|
| GPT-4o | $2.50 | $10.00 | — |
| Claude Sonnet 4 | $3.00 | $15.00 | — |
| Qwen2.5-72B (API) | $0.50 | $2.00 | — |
| Qwen3-32B (локальная) | $0.00 | $0.00 | ~$0.10 |
| Qwen3-8B (локальная) | $0.00 | $0.00 | ~$0.05 |
Если вы обрабатываете тысячи запросов за сессию, даже $0.05 на электричество лучше, чем $15 за M токенов.
Бюджетная маршрутизация переходит на более дешёвые варианты по мере расходования средств:
class CostAwareRouter:
    def __init__(self, budget_per_session: float = 0.10):
        self.budget = budget_per_session
        self.spent = 0.0
        self.models = {
            "cheap": {"model": "qwen3-8B", "cost": 0.0},
            "medium": {"model": "qwen3-32b", "cost": 0.0},
            "expensive": {"model": "claude-sonnet-4", "cost": 0.000015},
        }

    def route(self, task: str) -> str:
        ratio = self.spent / self.budget
        if ratio < 0.5:
            return self.models["expensive"]["model"]
        elif ratio < 0.8:
            return self.models["medium"]["model"]
        return self.models["cheap"]["model"]
Качество ухудшается по мере перехода на более дешёвые модели. Вы начинаете с Claude, переходите на Qwen3-32B, а затем на Qwen3-8B. К концу длинной сессии результат заметно хуже. Насколько это важно, зависит от того, что вы строите.
Маршрутизация рутинного трафика на локальную модель, оставляя API для пограничных случаев, имеет и побочную пользу помимо экономии: она не позволяет вам угодить в ловушку гравитации данных, где каждая дообученная модель и каждая среда для оценки (eval harness) становятся привязанными к API одного провайдера.
Маршрутизация с учётом задержек
Интерактивные инструменты требуют быстрого первого токена. Пакетные задачи могут ждать. Разница обычно составляет фактор пять в размере модели.
| Сценарий использования | Первый токен | Полное выполнение | Максимальный размер модели |
|---|---|---|---|
| Чат в реальном времени | < 200 мс | < 2 с | < 7B |
| Интерактивные инструменты | < 500 мс | < 5 с | < 14B |
| Пакетная обработка | < 1 с | < 30 с | Любой |
| Исследование/анализ | < 2 с | < 60 с | Любой |
Когда вы транслируете токены пользователю, задержка первого токена — это то, что он ощущает. Модель на 32B, которая тратит полсекунды на старт, ощущается медлительной по сравнению с моделью на 1.5B, которая выдает результат мгновенно.
class LatencyAwareRouter:
    def __init__(self):
        self.model_latencies = {
            "qwen3-1.7b": {"first_token": 0.05, "complete": 0.5},
            "qwen3-8B": {"first_token": 0.15, "complete": 2.0},
            "qwen3-32b": {"first_token": 0.5, "complete": 10.0},
            "claude-sonnet-4": {"first_token": 0.3, "complete": 5.0},
        }

    def route(self, target_latency: float) -> str:
        for model, latencies in sorted(
            self.model_latencies.items(),
            key=lambda x: x[1]["complete"]
        ):
            if latencies["complete"] <= target_latency:
                return model
        return "qwen3-1.7b"
Показатели задержки приблизительны — они зависят от вашего оборудования, квантования и размера батча. Измеряйте на своей настройке.
Стратегии отката (Fallback)
Модели ошибаются. API вводит лимиты на частоту запросов. Проходят тайм-ауты. Рабочий паттерн — это цепочка отката, выстроенная от наилучшей к самой надёжной:
class FallbackRouter:
    def __init__(self):
        self.fallback_chain = [
            {"model": "claude-sonnet-4", "timeout": 30},
            {"model": "qwen2.5-72b", "timeout": 60},
            {"model": "qwen3-32b", "timeout": 120},
            {"model": "qwen3-8b", "timeout": 300},
        ]

    def route_with_fallback(self, prompt: str) -> str:
        for config in self.fallback_chain:
            try:
                return self.call_model(
                    config["model"], prompt,
                    timeout=config["timeout"]
                )
            except (TimeoutError, APIError) as e:
                log.warning(f"Model {config['model']} failed: {e}")
                continue
        raise RuntimeError("All fallback models failed")
Последняя модель в цепочке должна быть локальной. Она медленнее, но не падёт из-за сетевой проблемы или API-ключа.
Когда маршрутизация полезна
Маршрутизация имеет смысл, если ваша нагрузка смешанная. Если вы делаете классификацию, суммирование и рассуждения в одной системе, маршрутизатор экономит деньги и время задержки.
Она бессмысленна, если всё, что вы делаете, имеет одинаковую сложность. Просто используйте модель, которая хорошо справляется с этой задачей. Маршрутизатор добавляет сложность, в которой вы не нуждаетесь.
Ранняя прототипация — ещё одна причина пропустить этот этап. Заставьте задачу работать с одной моделью, а затем добавьте маршрутизацию, когда стоимость или задержка действительно станут проблемой.
Компромиссы
Каждая стратегия маршрутизации оптимизирует одно за счёт другого:
- Одна модель — простейший вариант, самый дорогой, стабильное качество
- Основанная на возможностях — лучшая стоимость, более высокое качество на задачу, средняя сложность
- С учётом стоимости — самая дешёвая, качество варьируется, средняя сложность
- С учётом задержек — самая быстрая, может жертвовать качеством, средняя сложность
- Гибридная — лучшее из всего, но самая сложная в реализации
Продакшен-системы обычно сходятся на гибридном подходе. Начните с маршрутизации на основе возможностей, добавьте учёт стоимости, когда придёт счёт, добавьте учёт задержек, когда пользователи начнут жаловаться на медлительность.
Связанные материалы
- Оптимизация стоимости для систем LLM — управление токен-бюджетом, кэширование, модели отката
- Ограничители (Guardrails) для LLM на практике — валидация ввода, фильтрация вывода, безопасность
- Проектирование многомоделных систем — архитектура для нескольких моделей
- Решающие LLM: когда модели нужно принимать решения — и когда не стоит — таксономия ролей принятия решений за выбором уровня, с эскалацией на основе уверенности
- Архитектура LLM — системный столп проектирования: маршрутизация, стоимость, ограничители и оркестрация
