
El auge y la caída de OpenClaw: cronología y las razones reales detrás del colapso
OpenClaw creció rápidamente. Luego desapareció más rápido.
OpenClaw no fracasó como producto. Perdió su combustible.
OpenClaw creció rápidamente. Luego desapareció más rápido.
OpenClaw no fracasó como producto. Perdió su combustible.
Sirva e intercambie LLMs sin reinicios.
Durante mucho tiempo, llama.cpp tuvo una limitación flagrante:
solo se podía servir un modelo por proceso, y cambiar de modelo implicaba un reinicio.
Crea habilidades de Claude que resistan el trabajo real
La mayoría de los equipos utilizan mal las Claude Skills de una de dos maneras. O convierten SKILL.md en un vertedero de información, o nunca se alejan de los enormes prompts copiados y pegados.
Configuraciones de Hermes con prioridad en el perfil para cargas de trabajo serias
El asistente de IA Hermes, documentado oficialmente como Hermes Agent, no está posicionado como un simple envoltorio de chat.
Las habilidades que valen la pena conservar y las que hay que omitir
OpenClaw tiene dos historias de extensiones y es fácil confundirlas.
Los complementos (plugins) amplían el tiempo de ejecución. Las habilidades (skills) amplían el comportamiento del agente.
Primero los complementos. Breve denominación de las habilidades.
Este artículo trata sobre los plugins de OpenClaw: paquetes de puerta de enlace nativa que añaden canales, proveedores de modelos, herramientas, voz, memoria, medios, búsqueda web y otras superficies de tiempo de ejecución.
Cómo están realmente estructurados los sistemas OpenClaw
OpenClaw parece simple en las demostraciones. En producción, se convierte en un sistema.
Las suscripciones a Claude ya no impulsan agentes
La puerta trasera silenciosa que impulsó una ola de experimentación con agentes ahora está cerrada.
Búsqueda de IA autoalojada con LLMs locales
Vane es una de las entradas más pragmáticas en el espacio de “búsqueda de IA con citas”: un motor de respuestas autoalojado que combina la recuperación en tiempo real de la web con LLMs locales o en la nube, manteniendo toda la pila bajo tu control.
Programación con agentes, ahora con backends de modelos locales.
Claude Code no es autocompletado con mejor marketing. Es una herramienta de codificación agéntica: lee tu base de código, edita archivos, ejecuta comandos y se integra con tus herramientas de desarrollo.
Instalación y guía de inicio rápido del agente Hermes para desarrolladores
El Agente Hermes es un asistente de IA autoalojado y agnóstico de modelo que se ejecuta en una máquina local o en un VPS de bajo coste, funciona a través de interfaces de terminal y mensajería, y mejora con el tiempo convirtiendo las tareas repetitivas en habilidades reutilizables.
Instala TGI, despliega rápido, depura más rápido.
Text Generation Inference (TGI) tiene una energía muy específica. No es el último en llegar en la calle de la inferencia, pero es el que ya aprendió cómo se rompen las cosas en producción -
Velocidad de tokens de llama.cpp con 16 GB de VRAM (tablas).
Aquí estoy comparando la velocidad de varios LLM que se ejecutan en una GPU con 16GB de VRAM, y eligiendo el mejor para autoalojar.
Servidor Ollama con prioridad en composición, GPU y persistencia.
Ollama funciona muy bien en hardware físico (bare metal). Se vuelve aún más interesante cuando lo tratas como un servicio: un punto de conexión estable, versiones fijas, almacenamiento persistente y una GPU que está disponible o no lo está.
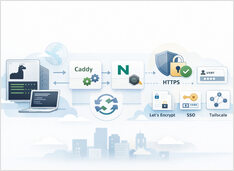
HTTPS con Ollama sin interrumpir las respuestas en streaming.
Ejecutar Ollama detrás de un proxy inverso es la forma más sencilla de obtener HTTPS, control de acceso opcional y un comportamiento de transmisión predecible.
Sirva modelos abiertos rápidamente con SGLang.
SGLang es un marco de servicio de alto rendimiento para grandes modelos de lenguaje y modelos multimodales, diseñado para ofrecer inferencia de baja latencia y alto rendimiento en todo, desde una sola GPU hasta clústeres distribuidos.