Les plugins SEO pour WordPress ajoutent la métadonnée, les plans du site, les données structurées et la couche d’IA au-dessus du cœur de WordPress, et en 2026, cette couche inclut des plugins qui exécutent l’inférence sur votre propre matériel.
Le SEO auto-hébergé couvre désormais les crawlers, les tableaux de bord Search Console, les suiveurs de positions, les serveurs MCP et l’IA locale. Ce guide compare les principales plateformes open source et les fonctionnalités qui fonctionnent sans les API SEO payantes.
Agents auto-hébergés qui recherchent au-delà de la simple recherche
Deep Research est devenu une catégorie logicielle à part entière, et non plus un simple modèle pointé vers une case de recherche. Cet article compare douze systèmes auto-hébergés et les architectures de recherche qui se cachent derrière.
Ollama et llama.cpp sont souvent comparés comme s’ils étaient des moteurs d’inférence rivaux. Le véritable choix se fait entre un service de gestion de modèles et un kit d’outils que vous pilotez directement.
ROCm et Vulkan accélèrent tous deux les GPU AMD pour l’hébergement local de LLM, mais ils ne sont pas interchangeables. Le bon choix dépend du moteur, du GPU et de la charge de travail.
Un modèle peut revendiquer une fenêtre de contexte de 128K et échouer pourtant à 40K jetons sur un GPU de 16 Go. La limite architecturale ne promettait jamais que les poids, le cache KV, les tampons de calcul et le compositeur de bureau tiendraient simultanément sur votre carte.
Pourquoi votre pile d’IA devient de plus en plus collante chaque mois.
Chaque appel API ressemble à une simple transaction – jusqu’au moment où ils s’accumulent au point que vos données de fine-tuning, vos harnais d’évaluation et vos schémas d’outils sont tous façonnés autour d’un seul fournisseur, et que le changement ne consiste plus en une simple modification de routage.
Ollama est l’une des méthodes les plus simples pour exécuter un modèle de langage local, mais la praticité peut masquer le moment où une expérience locale se transforme en service de déduction partagé nécessitant une meilleure planification et une meilleure observabilité.
Vane est l’une des entrées les plus pragmatiques de l’espace de la « recherche IA avec citations » : un moteur de réponses auto-hébergé qui mêle la récupération web en direct avec des LLM locaux ou cloud, tout en gardant toute la pile sous votre contrôle.
Ollama est à son meilleur lorsque l’on le traite comme un démon local : la CLI et vos applications communiquent avec une API HTTP en boucle locale (loopback), et le reste du réseau ignore son existence.
Serveur Ollama axé sur la composition, avec GPU et persistance.
Ollama fonctionne très bien sur du matériel nu. Cela devient encore plus intéressant lorsque vous la traitez comme un service : un point de terminaison stable, des versions épinglées, un stockage persistant et une carte graphique (GPU) qui est soit disponible, soit ne l’est pas.
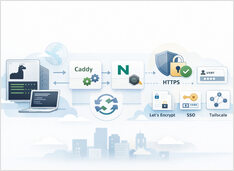
HTTPS Ollama sans interrompre les réponses en flux.
Exécuter Ollama derrière un proxy inversé est le moyen le plus simple d’obtenir HTTPS, un contrôle d’accès facultatif et un comportement de streaming prévisible.
Si vous travaillez sur la génération augmentée par récupération (RAG), cette section explique les incorporations de texte (text embeddings) en termes simples : ce qu’elles sont, comment elles s’intègrent dans la recherche et la récupération, et comment appeler deux configurations locales courantes depuis Python en utilisant Ollama ou une API HTTP compatible OpenAI (comme le font de nombreux serveurs basés sur llama.cpp).
Test LLM OpenCode — statistiques de codage et de précision
J’ai testé comment OpenCode fonctionne avec plusieurs LLM hébergés localement sur Ollama et llama.cpp, et j’ai ajouté pour comparaison quelques modèles gratuits provenant d’OpenCode Zen.
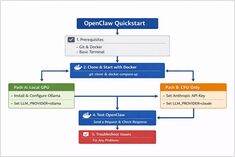
OpenClaw est un assistant IA auto-hébergé conçu pour fonctionner avec des runtime de LLM locaux comme Ollama ou avec des modèles cloud tels que Claude Sonnet.
Strategic guide to hosting large language models locally with Ollama, llama.cpp, vLLM, or in the cloud. Compare tools, performance trade-offs, and cost considerations.