Ai

Les ASIC pour LLM et les puces d’inférence spécialisées (pourquoi ils sont importants)

Les ASIC pour LLM et les puces d’inférence spécialisées (pourquoi ils sont importants)

Les ASIC et les puces sur mesure améliorent la vitesse et l’efficacité de l’inférence des LLM

L’avenir de l’IA ne concerne pas seulement des modèles plus intelligents. Il s’agit également de la silice capable de s’adapter à la manière dont ces modèles sont réellement servis. Le matériel spécialisé pour l’inférence LLM suit une voie rappelant le passage des GPU aux ASIC conçus sur mesure pour le minage de Bitcoin, mais avec des contraintes plus strictes car les modèles et les recettes de précision évoluent constamment.
DGX Spark face Mac Studio : analyse comparative des prix du superordinateur personnel IA de NVIDIA

DGX Spark face Mac Studio : analyse comparative des prix du superordinateur personnel IA de NVIDIA

Disponibilité, prix de vente réels dans six pays et comparaison avec le Mac Studio.

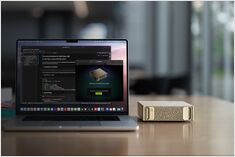
NVIDIA DGX Spark est bien réel, en vente depuis le 15 octobre 2025, et destiné aux développeurs CUDA ayant besoin de travailler localement avec des LLM grâce à une pile IA NVIDIA intégrée. Le prix de détail US est de 3 999 $ ; les prix de détail au Royaume-Uni/Allemagne/Japon sont plus élevés en raison de la TVA et des canaux de distribution. Les prix publics en AUD/KRW ne sont pas encore largement affichés.

Ollama et l’enshittification – les premiers signes

Ollama et l’enshittification – les premiers signes

Ma vision de l’état actuel du développement d’Ollama

Ollama est rapidement devenu l’un des outils les plus populaires pour exécuter des LLM localement. Son CLI simple et sa gestion de modèles optimisée en ont fait une option incontournable pour les développeurs souhaitant travailler avec des modèles d’IA en dehors du cloud.

Interfaces de chat pour les instances locales d'Ollama

Interfaces de chat pour les instances locales d'Ollama

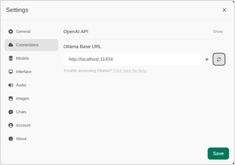
Aperçu rapide des interfaces utilisateur les plus remarquables pour Ollama en 2025

Localement hébergé, Ollama permet d’exécuter des modèles de langage sur votre propre machine, mais son utilisation via la ligne de commande n’est pas très conviviale.
Voici plusieurs projets open source qui proposent des interfaces du style ChatGPT qui se connectent à un Ollama local.

Détection d'objets avec Tensorflow

Détection d'objets avec Tensorflow

Il y a un certain temps, j'ai entraîné un détecteur d'objets AI.

Un froid jour d’hiver en juillet… c’est-à-dire en Australie… j’ai ressenti le besoin urgent d’entraîner un modèle d’IA pour détecter les barres d’armature en béton non coupées…