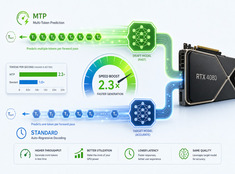
Décodage spéculatif : inférence LLM 20 à 50 % plus rapide
Inférence LLM plus rapide sans perte de qualité : un guide pratique
Un modèle de 70B génère un jeton par passe avant, et chaque passe recharge les poids depuis la VRAM, calcule l’attention sur l’ensemble du contexte et synchronise la mémoire. Entre les jetons, le GPU reste inactif pendant qu’il attend la résolution des dépendances séquentielles.