
Open WebUI : Interface auto-hébergée pour LLM
Alternative auto-hébergée à ChatGPT pour les LLM locaux
Open WebUI est une interface web auto-hébergée puissante, extensible et riche en fonctionnalités pour interagir avec les grands modèles de langage.
Alternative auto-hébergée à ChatGPT pour les LLM locaux
Open WebUI est une interface web auto-hébergée puissante, extensible et riche en fonctionnalités pour interagir avec les grands modèles de langage.
Installer, déployer et optimiser vLLM en 2026
vLLM est un moteur d’inférence et de service à haut débit et économe en mémoire pour les modèles de langage de grande taille (LLM), développé par le laboratoire Sky Computing de l’Université de Californie à Berkeley.
Réflexions sur les LLM pour Cognee auto-hébergé
Choisir le meilleur LLM pour Cognee exige de trouver un équilibre entre la qualité de construction des graphes, les taux de hallucination et les contraintes matérielles. Cognee excelle avec des modèles plus grands et peu hallucinants (32B+) via Ollama mais des options de taille moyenne conviennent pour des configurations plus légères.
Comparez les meilleurs outils d'hébergement local de LLM en 2026. Maturation des API, support du matériel, outil d'appel et cas d'usage concrets.
L’exécution locale de LLM (grands modèles de langage) est désormais pratique pour les développeurs, les startups et même les équipes d’entreprise. Mais le choix du bon outil — Ollama, vLLM, LM Studio, LocalAI ou d’autres — dépend de vos objectifs :
Configurez les tailles de contexte dans Docker Model Runner avec des contournements
Configuration des tailles de contexte dans Docker Model Runner est plus complexe qu’elle ne devrait l’être.
Activez l'accélération GPU pour Docker Model Runner avec prise en charge NVIDIA CUDA
Docker Model Runner est l’outil officiel de Docker pour exécuter des modèles d’IA localement, mais l’activation de l’accélération GPU NVidia dans Docker Model Runner nécessite une configuration spécifique.
Référence rapide des commandes Docker Model Runner
Docker Model Runner (DMR) est la solution officielle de Docker pour exécuter des modèles d’IA localement, introduite en avril 2025. Cette fiche pratique fournit un référentiel rapide pour toutes les commandes essentielles, les configurations et les bonnes pratiques.
Comparez Docker Model Runner et Ollama pour un LLM local
Exécuter des grands modèles de langage (LLMs) localement a de plus en plus de popularité pour la confidentialité, le contrôle des coûts et les capacités hors ligne. Le paysage s’est considérablement transformé en avril 2025 lorsque Docker a introduit Docker Model Runner (DMR), sa solution officielle pour le déploiement de modèles d’IA.
Intégrer Ollama avec Go : guide du SDK, exemples et bonnes pratiques en production.
Ce guide fournit un aperçu complet des SDK Go pour Ollama et compare leurs fonctionnalités.
+ Exemples concrets utilisant des LLMs de réflexion
Dans cet article, nous allons explorer deux façons de connecter votre application Python à Ollama : 1. Via HTTP REST API ; 2. Via la bibliothèque Python officielle d’Ollama.
Ma vision de l’état actuel du développement d’Ollama
Ollama est rapidement devenu l’un des outils les plus populaires pour exécuter des LLM localement. Son CLI simple et sa gestion de modèles optimisée en ont fait une option incontournable pour les développeurs souhaitant travailler avec des modèles d’IA en dehors du cloud.
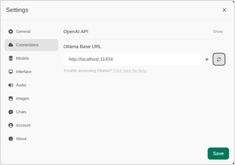
Aperçu rapide des interfaces utilisateur les plus remarquables pour Ollama en 2025
Localement hébergé, Ollama permet d’exécuter des modèles de langage sur votre propre machine, mais son utilisation via la ligne de commande n’est pas très conviviale.
Voici plusieurs projets open source qui proposent des interfaces du style ChatGPT qui se connectent à un Ollama local.
qwen3 8b, 14b et 30b, devstral 24b, mistral small 24b
Dans ce test, je suis en train de comparer comment différents LLMs hébergés sur Ollama traduisent une page Hugo en anglais vers l’allemand.
Liste courte des fournisseurs de LLM
L’utilisation des LLM n’est pas très coûteuse, il pourrait ne pas être nécessaire d’acheter un nouveau GPU impressionnant. Voici une liste si fournisseurs de LLM en nuage avec les LLM qu’ils hébergent.
« Comparaison de deux modèles deepseek-r1 avec deux modèles de base »
DeepSeek’s première génération de modèles de raisonnement avec des performances comparables à celles d’OpenAI-o1, incluant six modèles denses distillés à partir de DeepSeek-R1 basés sur Llama et Qwen.
Liste mise à jour des commandes Ollama – ls, ps, run, serve, etc.
Cette Aide-mémoire CLI Ollama se concentre sur les commandes que vous utilisez au quotidien (ollama ls, ollama serve, ollama run, ollama ps, la gestion des modèles et les flux de travail courants), avec des exemples que vous pouvez copier/coller.