
Restricción de LLM mediante salida estructurada: Ollama, Qwen3 y Python o Go
Un par de formas de obtener una salida estructurada de Ollama
Modelos de Lenguaje a Gran Escala (LLM) son poderosos, pero en producción rara vez deseamos párrafos de formato libre. En cambio, queremos datos predecibles: atributos, hechos u objetos estructurados que puedes proporcionar a una aplicación. Eso es la Salida estructurada de LLM.
La aplicación de esquemas reduce la frecuencia con la que los logits incorrectos se convierten en JSON inválido, pero la temperatura y las penalizaciones siguen importando para las tormentas de reintentos; consulta los parámetros de inferencia agéntica para Qwen y Gemma cuando combines restricciones de format con agentes.
La capa de servicio aún necesita lógica de parseo-normalización-validación, consulta la validación de salida estructurada de LLM en Python que resiste—porque Ollama y los clientes pueden no coincidir en las cadenas exactas incluso cuando format está establecido.
Hace algún tiempo, Ollama introdujo soporte para salida estructurada (anuncio), lo que hace posible restringir las respuestas de un modelo para que coincidan con un esquema JSON. Esto libera pipelines de extracción de datos consistentes para tareas como catalogar funciones de LLM, realizar pruebas de rendimiento de modelos o automatizar la integración del sistema.
En esta publicación, cubriremos:
- Qué es la salida estructurada y por qué importa
- Forma sencilla de obtener salida estructurada de LLM
- Cómo funciona la nueva función de Ollama
- Ejemplos de extracción de capacidades de LLM:
¿Qué es la Salida Estructurada?
Normalmente, los LLM generan texto libre:
“El Modelo X soporta razonamiento con cadena de pensamiento, tiene una ventana de contexto de 200K y habla inglés, chino y español.”
Eso es legible, pero difícil de analizar.
En cambio, con la salida estructurada, solicitamos un esquema estricto:
{
  "name": "Modelo X",
  "supports_thinking": true,
  "max_context_tokens": 200000,
  "languages": ["inglés", "chino", "español"]
}
Este JSON es fácil de validar, almacenar en una base de datos o proporcionar a una interfaz de usuario.
Forma sencilla de obtener Salida Estructurada de LLM
A veces los LLM entienden qué es el esquema y podemos pedirle al LLM que devuelva la salida en JSON usando un esquema particular. El modelo Qwen3 de Alibaba está optimizado para el razonamiento y las respuestas estructuradas. Puedes instruirlo explícitamente para que responda en JSON.
Ejemplo 1: Usando Qwen3 con ollama en Python, solicitando JSON con esquema
import json
import ollama

prompt = """
You are a structured data extractor.
Return JSON only.
Text: "Elon Musk is 53 and lives in Austin."
Schema: { "name": string, "age": int, "city": string }
"""

response = ollama.chat(model="qwen3", messages=[{"role": "user", "content": prompt}])
output = response['message']['content']

# Parse JSON
try:
    data = json.loads(output)
    print(data)
except Exception as e:
    print("Error parsing JSON:", e)
Salida:
{"name": "Elon Musk", "age": 53, "city": "Austin"}
Aplicación de Validación de Esquemas con Pydantic
Para evitar salidas malformadas, puedes validar contra un esquema Pydantic en Python.
from pydantic import BaseModel

class Person(BaseModel):
    name: str
    age: int
    city: str

# Suppose 'output' is the JSON string from Qwen3
data = Person.model_validate_json(output)
print(data.name, data.age, data.city)
Esto asegura que la salida cumpla con la estructura esperada.
Salida Estructurada de Ollama
Ahora Ollama te permite pasar un esquema en el parámetro format. El modelo entonces se ve restringido a responder solo en JSON que cumpla con el esquema (documentación).
En Python, típicamente defines tu esquema con Pydantic y dejas que Ollama lo use como un esquema JSON.
Ejemplo 2: Extraer Metadatos de Funciones de LLM
Supongamos que tienes un fragmento de texto que describe las capacidades de un LLM:
“Qwen3 tiene un fuerte soporte multilingüe (inglés, chino, francés, español, árabe). Permite pasos de razonamiento (cadena de pensamiento). La ventana de contexto es de 128K tokens.”
Quieres datos estructurados:
from pydantic import BaseModel
from typing import List
from ollama import chat

class LLMFeatures(BaseModel):
    name: str
    supports_thinking: bool
    max_context_tokens: int
    languages: List[str]

prompt = """
Analyze the following description and return the model’s features in JSON only.
Model description:
'Qwen3 has strong multilingual support (English, Chinese, French, Spanish, Arabic).
It allows reasoning steps (chain-of-thought).
The context window is 128K tokens.'
"""

resp = chat(
    model="qwen3",
    messages=[{"role": "user", "content": prompt}],
    format=LLMFeatures.model_json_schema(),
    options={"temperature": 0},
)

print(resp.message.content)
Salida posible:
{
  "name": "Qwen3",
  "supports_thinking": true,
  "max_context_tokens": 128000,
  "languages": ["inglés", "chino", "francés", "español", "árabe"]
}
Ejemplo 3: Comparar Varios Modelos
Proporciona descripciones de varios modelos y extrae en forma estructurada:
from typing import List

class ModelComparison(BaseModel):
    models: List[LLMFeatures]

prompt = """
Extract features of each model into JSON.

1. Llama 3.1 supports reasoning. Context window is 128K. Languages: English only.
2. GPT-4 Turbo supports reasoning. Context window is 128K. Languages: English, Japanese.
3. Qwen3 supports reasoning. Context window is 128K. Languages: English, Chinese, French, Spanish, Arabic.
"""

resp = chat(
    model="qwen3",
    messages=[{"role": "user", "content": prompt}],
    format=ModelComparison.model_json_schema(),
    options={"temperature": 0},
)

print(resp.message.content)
Salida:
{
  "models": [
    {
      "name": "Llama 3.1",
      "supports_thinking": true,
      "max_context_tokens": 128000,
      "languages": ["inglés"]
    },
    {
      "name": "GPT-4 Turbo",
      "supports_thinking": true,
      "max_context_tokens": 128000,
      "languages": ["inglés", "japonés"]
    },
    {
      "name": "Qwen3",
      "supports_thinking": true,
      "max_context_tokens": 128000,
      "languages": ["inglés", "chino", "francés", "español", "árabe"]
    }
  ]
}
Esto hace que sea trivial realizar pruebas de rendimiento, visualizar o filtrar modelos según sus funciones.
Ejemplo 4: Detectar Lagunas Automáticamente
Incluso puedes permitir valores null cuando falta un campo:
from typing import Optional

class FlexibleLLMFeatures(BaseModel):
    name: str
    supports_thinking: Optional[bool]
    max_context_tokens: Optional[int]
    languages: Optional[List[str]]
Esto asegura que tu esquema siga siendo válido incluso si alguna información es desconocida.
Beneficios, Precauciones y Mejores Prácticas
El uso de salida estructurada a través de Ollama (o cualquier sistema que lo soporte) ofrece muchas ventajas, pero también tiene algunas precauciones.
Beneficios
- Garantías más fuertes: El modelo es solicitado a conformarse a un esquema JSON en lugar de texto de formato libre.
- Parseo más fácil: Puedes ejecutar
json.loadsdirectamente o validar con Pydantic / Zod, en lugar de usar expresiones regulares o heurísticas. - Evolución basada en esquemas: Puedes versionar tu esquema, añadir campos (con valores predeterminados) y mantener la compatibilidad hacia atrás.
- Interoperabilidad: Los sistemas downstream esperan datos estructurados.
- Determinismo (mejor con temperatura baja): Cuando la temperatura es baja (p. ej., 0), el modelo tiene más probabilidades de adherirse estrictamente al esquema. La documentación de Ollama recomienda esto.
Precauciones y Errores Comunes
- Desajuste de esquema: El modelo aún puede desviarse, por ejemplo, omitir una propiedad requerida, reordenar claves o incluir campos adicionales. Necesitas validación.
- Esquemas complejos: Los esquemas JSON muy profundos o recursivos pueden confundir al modelo o llevar a fallos.
- Ambigüedad en el prompt: Si tu prompt es vago, el modelo puede adivinar campos o unidades incorrectamente.
- Inconsistencia entre modelos: Algunos modelos pueden ser mejores o peores cumpliendo las restricciones estructuradas.
- Límites de tokens: El esquema en sí mismo añade un costo de tokens al prompt o a la llamada de API.
Mejores Prácticas y Consejos (basados en el blog de Ollama + experiencia)
- Usa Pydantic (Python) o Zod (JavaScript) para definir tus esquemas y generar automáticamente esquemas JSON. Esto evita errores manuales.
- Incluye siempre instrucciones como “responder solo en JSON” o “no incluir comentarios o texto adicional” en tu prompt.
- Usa temperatura = 0 (o muy baja) para minimizar la aleatoriedad y maximizar la adhesión al esquema. Ollama recomienda el determinismo.
- Valida y posiblemente usa un plan de respaldo (p. ej., reintento o limpieza) cuando el análisis JSON falla o la validación del esquema falla.
- Comienza con un esquema más simple y luego extiéndelo gradualmente. No lo complices en exceso al principio.
- Incluye instrucciones de error útiles pero restringidas: p. ej., si el modelo no puede llenar un campo requerido, responde con
nullen lugar de omitirlo (si tu esquema lo permite).
Ejemplo en Go 1: Extrayendo Funciones de LLM
Aquí hay un simple programa en Go que le pide a Qwen3 una salida estructurada sobre las funciones de un LLM.
package main

import (
	"context"
	"encoding/json"
	"fmt"
	"log"

	"github.com/ollama/ollama/api"
)

type LLMFeatures struct {
	Name             string   `json:"name"`
	SupportsThinking bool     `json:"supports_thinking"`
	MaxContextTokens int      `json:"max_context_tokens"`
	Languages        []string `json:"languages"`
}

func main() {
	client, err := api.ClientFromEnvironment()
	if err != nil {
		log.Fatal(err)
	}

	prompt := `
  Analyze the following description and return the model’s features in JSON only.
  Description:
  "Qwen3 has strong multilingual support (English, Chinese, French, Spanish, Arabic).
  It allows reasoning steps (chain-of-thought).
  The context window is 128K tokens."
  `

	// Define the JSON schema for structured output
	formatSchema := map[string]any{
		"type": "object",
		"properties": map[string]any{
			"name": map[string]string{
				"type": "string",
			},
			"supports_thinking": map[string]string{
				"type": "boolean",
			},
			"max_context_tokens": map[string]string{
				"type": "integer",
			},
			"languages": map[string]any{
				"type": "array",
				"items": map[string]string{
					"type": "string",
				},
			},
		},
		"required": []string{"name", "supports_thinking", "max_context_tokens", "languages"},
	}

	// Convert schema to JSON
	formatJSON, err := json.Marshal(formatSchema)
	if err != nil {
		log.Fatal("Failed to marshal format schema:", err)
	}

	req := &api.GenerateRequest{
		Model:   "qwen3:8b",
		Prompt:  prompt,
		Format:  formatJSON,
		Options: map[string]any{"temperature": 0},
	}

	var features LLMFeatures
	var rawResponse string
	err = client.Generate(context.Background(), req, func(response api.GenerateResponse) error {
		// Accumulate content as it streams
		rawResponse += response.Response

		// Only parse when the response is complete
		if response.Done {
			if err := json.Unmarshal([]byte(rawResponse), &features); err != nil {
				return fmt.Errorf("JSON parse error: %v", err)
			}
		}
		return nil
	})
	if err != nil {
		log.Fatal(err)
	}

	fmt.Printf("Parsed struct: %+v\n", features)
}
Para compilar y ejecutar este programa de ejemplo en Go, supongamos que tenemos este archivo main.go en una carpeta ollama-struct,
Necesitamos ejecutar dentro de esta carpeta:
# initialise module
go mod init ollama-struct
# pull all the dependencise
go mod tidy
# build & execute
go build -o ollama-struct main.go
./ollama-struct
Ejemplo de Salida
Parsed struct: {Name:Qwen3 SupportsThinking:true MaxContextTokens:128000 Languages:[inglés chino francés español árabe]}
Ejemplo en Go 2: Comparando Varios Modelos
Puedes extender esto para extraer una lista de modelos para comparación.
  type ModelComparison struct {
		Models []LLMFeatures `json:"models"`
	}

	prompt = `
	Extract features from the following model descriptions and return as JSON:

	1. PaLM 2: This model has limited reasoning capabilities and focuses on basic language understanding. It supports a context window of 8,000 tokens. It primarily supports English language only.
	2. LLaMA 2: This model has moderate reasoning abilities and can handle some logical tasks. It can process up to 4,000 tokens in its context. It supports English, Spanish, and Italian languages.
	3. Codex: This model has strong reasoning capabilities specifically for programming and code analysis. It has a context window of 16,000 tokens. It supports English, Python, JavaScript, and Java languages.

	Return a JSON object with a "models" array containing all models.
	`

	// Define the JSON schema for model comparison
	comparisonSchema := map[string]any{
		"type": "object",
		"properties": map[string]any{
			"models": map[string]any{
				"type": "array",
				"items": map[string]any{
					"type": "object",
					"properties": map[string]any{
						"name": map[string]string{
							"type": "string",
						},
						"supports_thinking": map[string]string{
							"type": "boolean",
						},
						"max_context_tokens": map[string]string{
							"type": "integer",
						},
						"languages": map[string]any{
							"type": "array",
							"items": map[string]string{
								"type": "string",
							},
						},
					},
					"required": []string{"name", "supports_thinking", "max_context_tokens", "languages"},
				},
			},
		},
		"required": []string{"models"},
	}

	// Convert schema to JSON
	comparisonFormatJSON, err := json.Marshal(comparisonSchema)
	if err != nil {
		log.Fatal("Failed to marshal comparison schema:", err)
	}

	req = &api.GenerateRequest{
		Model:   "qwen3:8b",
		Prompt:  prompt,
		Format:  comparisonFormatJSON,
		Options: map[string]any{"temperature": 0},
	}

	var comp ModelComparison
	var comparisonResponse string
	err = client.Generate(context.Background(), req, func(response api.GenerateResponse) error {
		// Accumulate content as it streams
		comparisonResponse += response.Response

		// Only parse when the response is complete
		if response.Done {
			if err := json.Unmarshal([]byte(comparisonResponse), &comp); err != nil {
				return fmt.Errorf("JSON parse error: %v", err)
			}
		}
		return nil
	})
	if err != nil {
		log.Fatal(err)
	}

	for _, m := range comp.Models {
		fmt.Printf("%s: Context=%d, Languages=%v\n", m.Name, m.MaxContextTokens, m.Languages)
	}
Ejemplo de Salida
PaLM 2: Context=8000, Languages=[inglés]
LLaMA 2: Context=4000, Languages=[inglés español italiano]
Codex: Context=16000, Languages=[inglés Python JavaScript Java]
Por cierto, qwen3:4b en estos ejemplos funciona bien, igual que qwen3:8b.
Mejores Prácticas para Desarrolladores en Go
- Establece la temperatura en 0 para la máxima adhesión al esquema.
- Valida con
json.Unmarshaly usa un plan de respaldo si el análisis falla. - Mantén los esquemas simples — las estructuras JSON profundamente anidadas o recursivas pueden causar problemas.
- Permite campos opcionales (usa
omitemptyen las etiquetas de estructuras de Go) si esperas datos faltantes. - Agrega reintentos si el modelo ocasionalmente emite JSON inválido.
Ejemplo completo: Dibujando un Gráfico con Especificaciones de LLM (Paso a paso: de JSON estructurado a tablas de comparación)
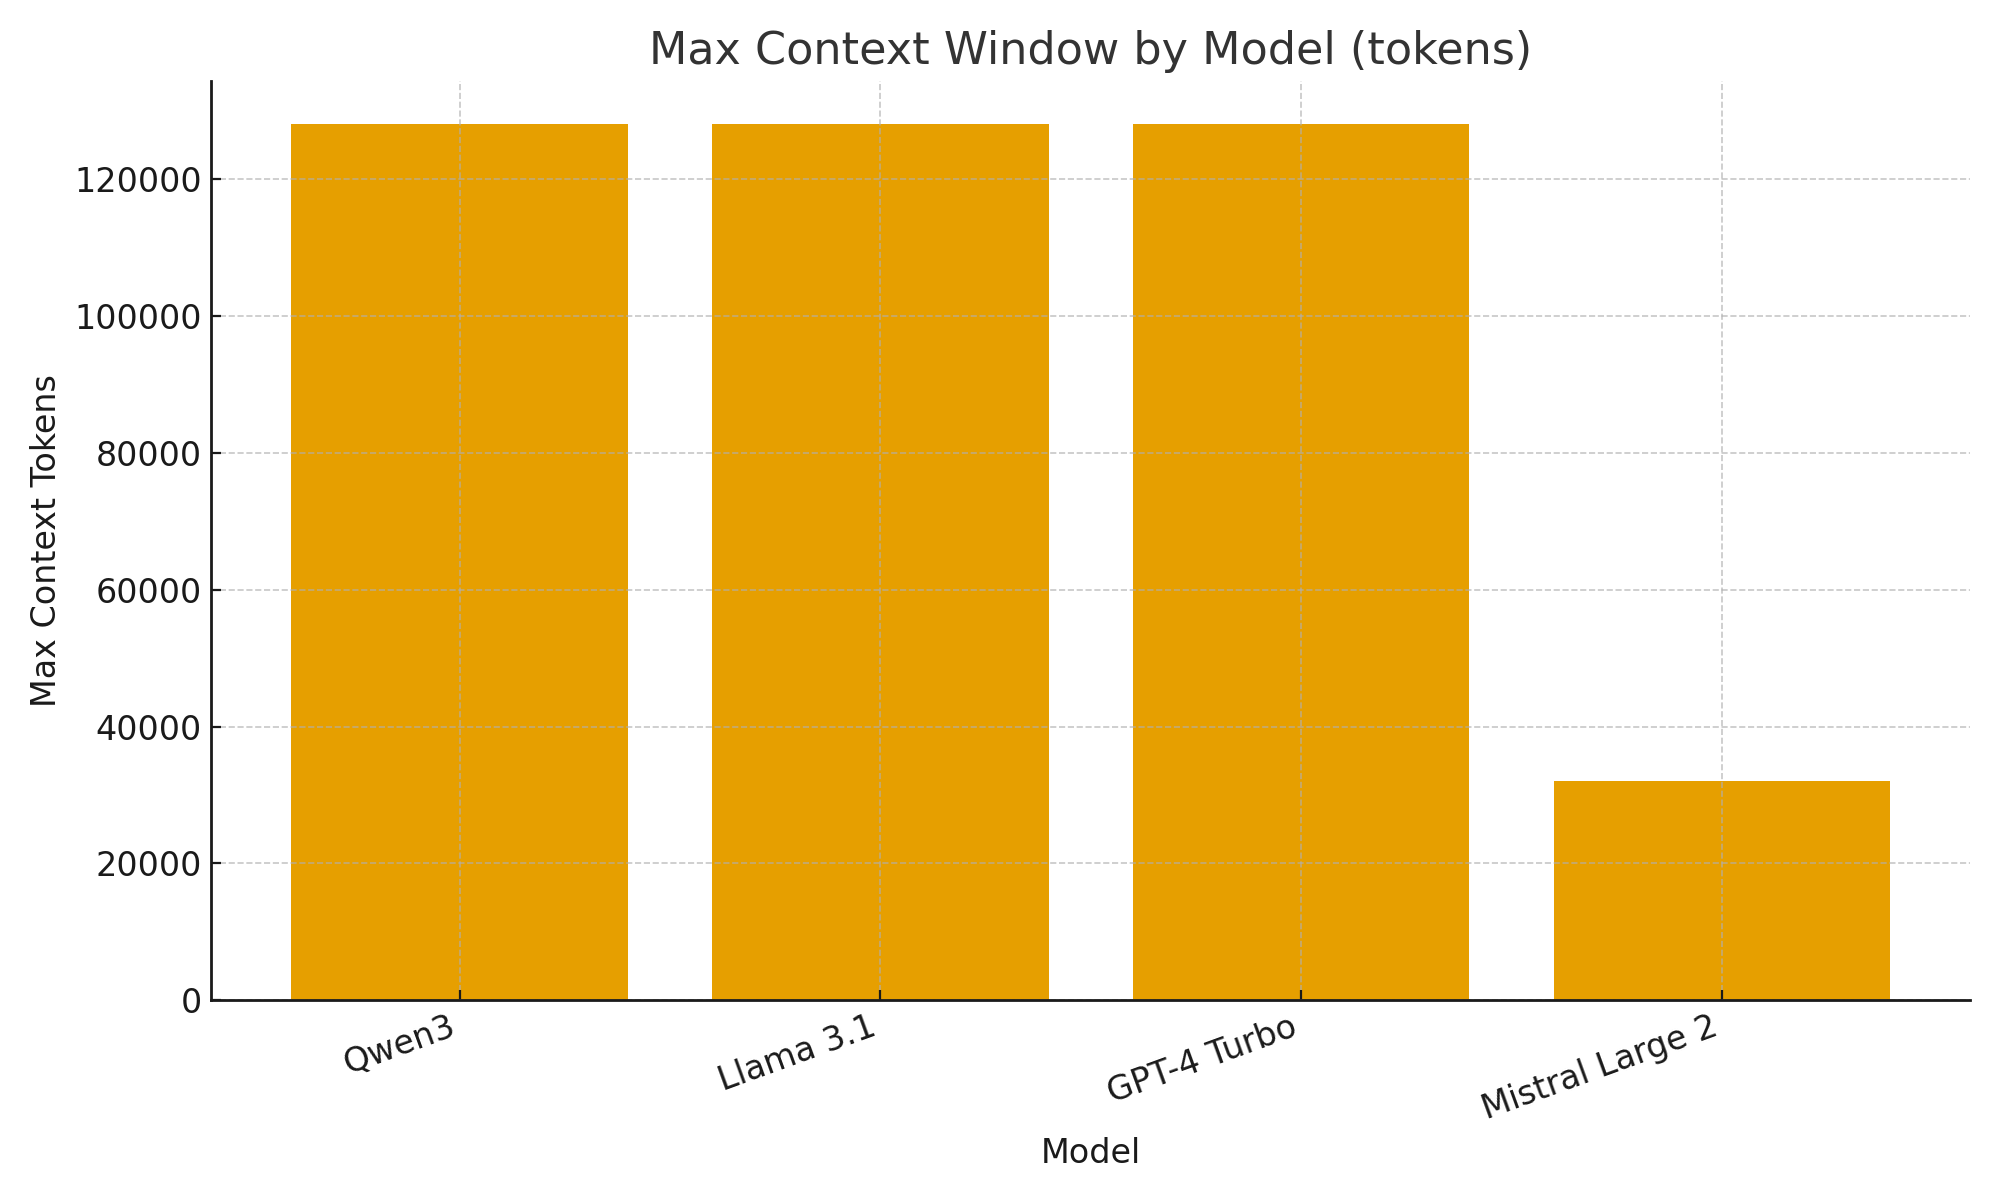
- Define un esquema para los datos que deseas
Usa Pydantic para poder tanto (a) generar un Esquema JSON para Ollama y (b) validar la respuesta del modelo.
from pydantic import BaseModel
from typing import List, Optional

class LLMFeatures(BaseModel):
    name: str
    supports_thinking: bool
    max_context_tokens: int
    languages: List[str]
- Pide a Ollama que devuelva solo JSON en esa forma
Pasa el esquema en format= y baja la temperatura para el determinismo.
from ollama import chat

prompt = """
Extract features for each model. Return JSON only matching the schema.
1) Qwen3 supports chain-of-thought; 128K context; English, Chinese, French, Spanish, Arabic.
2) Llama 3.1 supports chain-of-thought; 128K context; English.
3) GPT-4 Turbo supports chain-of-thought; 128K context; English, Japanese.
"""

resp = chat(
    model="qwen3",
    messages=[{"role": "user", "content": prompt}],
    format={"type": "array", "items": LLMFeatures.model_json_schema()},
    options={"temperature": 0}
)

raw_json = resp.message.content  # JSON list of LLMFeatures
- Validar y normalizar
Siempre valida antes de usarlo en producción.
from pydantic import TypeAdapter

adapter = TypeAdapter(list[LLMFeatures])
models = adapter.validate_json(raw_json)  # -> list[LLMFeatures]
- Construir una tabla de comparación (pandas)
Convierte tus objetos validados en un DataFrame que puedes ordenar/filtrar y exportar.
import pandas as pd

df = pd.DataFrame([m.model_dump() for m in models])
df["languages_count"] = df["languages"].apply(len)
df["languages"] = df["languages"].apply(lambda xs: ", ".join(xs))

# Reorder columns for readability
df = df[["name", "supports_thinking", "max_context_tokens", "languages_count", "languages"]]

# Save as CSV for further use
df.to_csv("llm_feature_comparison.csv", index=False)
- (Opcional) Visuales rápidas
Los gráficos simples te ayudan a observar rápidamente las diferencias entre modelos.
import matplotlib.pyplot as plt

plt.figure()
plt.bar(df["name"], df["max_context_tokens"])
plt.title("Max Context Window by Model (tokens)")
plt.xlabel("Model")
plt.ylabel("Max Context Tokens")
plt.xticks(rotation=20, ha="right")
plt.tight_layout()
plt.savefig("max_context_window.png")
En resumen
Con el nuevo soporte para salida estructurada de Ollama, puedes tratar los LLM no solo como chatbots, sino como motores de extracción de datos.
Los ejemplos anteriores mostraron cómo extraer automáticamente metadatos estructurados sobre funciones de LLM como soporte de pensamiento, tamaño de la ventana de contexto y idiomas soportados — tareas que de otro modo requerirían un análisis frágil.
Ya sea que estés construyendo un catálogo de modelos de LLM, un panel de evaluación o un asistente de investigación con IA, las salidas estructuradas hacen que la integración sea fluida, confiable y lista para producción.
