
Optimización de costes para sistemas de LLM: dónde se gasta realmente el dinero
Gasta tokens donde realmente importan.
Los costos de los LLM escalan de forma lineal con el uso. Un sistema que procesa 10.000 solicitudes al día a 0,01 dólares por solicitud cuesta 100 dólares diarios, es decir, 365 dólares al año. A escala empresarial, eso supera los 10.000 dólares.
La optimización de costos no se trata de recortar en lo importante. Se trata de gastar tokens donde realmente importan.
Cada token que desperdicias es un token que podrías haber usado para obtener una mejor respuesta.
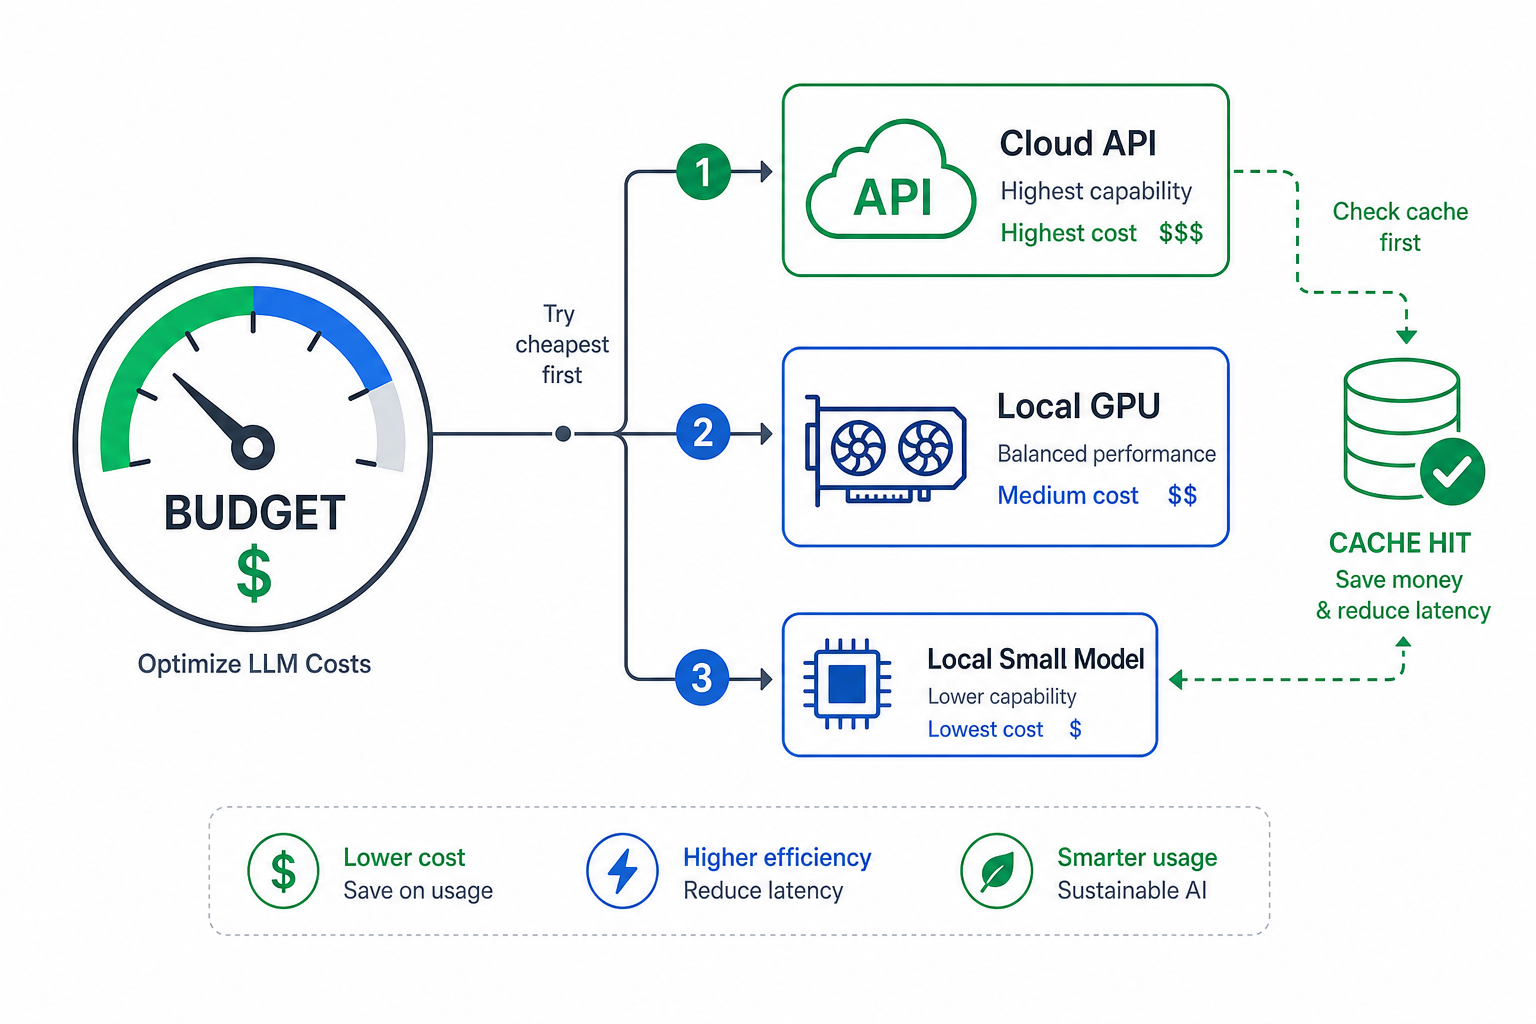
Presupuestación de tokens
La forma más sencilla de controlar los costos es establecer límites. Por sesión, por tarea o por día.
Estrategia 1: Presupuestos por sesión
Los presupuestos por sesión son directos:
class SessionBudget:
    def __init__(self, budget_tokens: int = 10000):
        self.budget = budget_tokens
        self.used = 0

    def allocate(self, tokens: int) -> bool:
        if self.used + tokens <= self.budget:
            self.used += tokens
            return True
        return False

    def remaining(self) -> int:
        return self.budget - self.used
Estrategia 2: Presupuestos por tarea
Los presupuestos por tarea son más útiles. Las diferentes tareas requieren diferentes cantidades de contexto:
task_budgets:
  classify:
    max_tokens: 100
    model: qwen3-1.7b
  summarize:
    max_tokens: 500
    model: qwen3-8b
  code_review:
    max_tokens: 2000
    model: qwen2.5-coder-7b
  reason:
    max_tokens: 4000
    model: qwen3-32b
Estrategia 3: Presupuestos adaptativos
Los presupuestos adaptativos se ajustan según lo que realmente ocurre. Si las tareas de clasificación utilizan consistentemente 80 tokens, deja de asignar 100:
class AdaptiveBudget:
    def __init__(self):
        self.task_history = {}

    def allocate(self, task_type: str) -> int:
        if task_type in self.task_history:
            return int(self.task_history[task_type] * 1.5)
        return 1000

    def record(self, task_type: str, tokens_used: int):
        if task_type not in self.task_history:
            self.task_history[task_type] = tokens_used
        else:
            self.task_history[task_type] = (
                0.9 * self.task_history[task_type] + 0.1 * tokens_used
            )
El promedio móvil exponencial (peso 0,9) significa que el uso reciente pesa más que el histórico. Ajusta el peso según cuán volátiles sean tus cargas de trabajo.
Inferencia por API vs. local
La inferencia local es más barata a gran escala. El punto de equilibrio depende de tu hardware y de las tarifas de la API.
| Modelo | API (US$/M tokens) | Costo local/hora | Punto de equilibrio |
|---|---|---|---|
| GPT-4o | $2,50 / $10,00 | — | N/A |
| Claude Sonnet 4 | $3,00 / $15,00 | — | N/A |
| Qwen2.5-72B | $0,50 / $2,00 | ~$0,50 | ~4 horas/día |
| qwen3-32b | $0,30 / $1,20 | ~$0,20 | ~2 horas/día |
| qwen3-8b | $0,10 / $0,40 | ~$0,05 | ~1 hora/día |
El cálculo de hardware:
| Hardware | Inversión inicial | Electricidad mensual | Punto de equilibrio vs API |
|---|---|---|---|
| RTX 3090 (usada) | $600 | $15 | ~4 meses |
| RTX 4090 | $1.500 | $20 | ~6 meses |
| RTX 5080 | $1.000 | $18 | ~5 meses |
| DGX Spark | $2.000 | $30 | ~8 meses |
Con un uso moderado, de una hora o más al día, la inferencia local se paga sola. Con un uso alto, los ahorros son dramáticos. El inconveniente es el capital inicial. Una RTX 5080 cuesta $1.000. Una factura de API se puede pausar; el hardware, no.
Este cálculo de equilibrio asume que puedes cambiar libremente de proveedor, lo cual suele ser el gran desconocido, más que el coste del hardware. Si tus datos de ajuste fino, tus arneses de evaluación y tus esquemas de herramientas ya están construidos en torno a la API de un proveedor, el verdadero coste de migración es el tiempo de ingeniería para desmontar esa dependencia, no el precio de una GPU. Gravedad de los datos: el verdadero coste de la IA centrada en APIs analiza ese mecanismo de bloqueo y ofrece una lista de verificación para evaluar cuánto profundizado ya estás en él, antes de realizar estos cálculos.
Estrategias de respaldo
Cuando tu modelo preferido es demasiado caro o demasiado lento, utiliza un modelo más económico como alternativa. La clave es saber cuándo la calidad es “suficiente”.
Estrategia 1: Respaldo basado en calidad
El respaldo basado en calidad prueba los modelos hasta que la salida cumpla con un umbral:
class QualityFallback:
    def __init__(self, quality_threshold: float = 0.8):
        self.threshold = quality_threshold
        self.models = [
            {"model": "claude-sonnet-4", "cost": 0.015},
            {"model": "qwen2.5-72b", "cost": 0.002},
            {"model": "qwen3-32b", "cost": 0.001},
            {"model": "qwen3-8b", "cost": 0.0004},
        ]

    def route(self, prompt: str) -> str:
        for model_config in self.models:
            result = self.call_model(model_config["model"], prompt)
            if self.evaluate_quality(result) >= self.threshold:
                return result
        return self.call_model(self.models[0]["model"], prompt)
El problema es la evaluación en sí. ¿Cómo mides la calidad sin llamar a otro modelo? Algunos sistemas utilizan un clasificador pequeño. Otros utilizan comprobaciones heurísticas: longitud, estructura, presencia de palabras clave. Ninguno de estos es perfecto.
Estrategia 2: Respaldo basado en latencia
El respaldo basado en latencia es más sencillo. Enruta hacia el modelo más rápido que cumpla tu presupuesto de tiempo:
class LatencyFallback:
    def __init__(self, max_latency: float = 5.0):
        self.max_latency = max_latency
        self.models = [
            {"model": "qwen3-1.7b", "latency": 0.5},
            {"model": "qwen3-8b", "latency": 2.0},
            {"model": "qwen3-32b", "latency": 10.0},
            {"model": "claude-sonnet-4", "latency": 5.0},
        ]

    def route(self, prompt: str) -> str:
        for model_config in sorted(self.models, key=lambda x: x["latency"]):
            if model_config["latency"] <= self.max_latency:
                return self.call_model(model_config["model"], prompt)
        return self.call_model(self.models[0]["model"], prompt)
Caché
La caché es la optimización de costos más infravalorada. Las indicaciones (prompts) idénticas ocurren con más frecuencia de lo que crees: solicitudes de clasificación, consultas tipo FAQ, llamadas repetidas a herramientas.
Estrategia 1: Caché de prompts
La caché exacta de prompts es sencilla:
import hashlib

class PromptCache:
    def __init__(self, max_size: int = 1000):
        self.cache = {}
        self.max_size = max_size

    def get(self, prompt: str) -> str | None:
        key = hashlib.sha256(prompt.encode()).hexdigest()
        return self.cache.get(key)

    def set(self, prompt: str, response: str):
        key = hashlib.sha256(prompt.encode()).hexdigest()
        if len(self.cache) >= self.max_size:
            self.cache.pop(next(iter(self.cache)))
        self.cache[key] = response
Estrategia 2: Caché semántica
La caché semántica es más útil. Captura prompts que son diferentes pero significan lo mismo:
from sentence_transformers import SentenceTransformer

class SemanticCache:
    def __init__(self, similarity_threshold: float = 0.95):
        self.model = SentenceTransformer('all-MiniLM-L6-v2')
        self.cache = {}
        self.threshold = similarity_threshold

    def get(self, prompt: str) -> str | None:
        prompt_embedding = self.model.encode([prompt])[0]
        for cached_prompt, cached_response in self.cache.items():
            cached_embedding = self.model.encode([cached_prompt])[0]
            similarity = self.cosine_similarity(
                prompt_embedding, cached_embedding
            )
            if similarity >= self.threshold:
                return cached_response
        return None

    def set(self, prompt: str, response: str):
        self.cache[prompt] = response
El umbral importa. 0,95 es agresivo: solo coinciden prompts muy similares. 0,85 es más permisivo pero conlleva el riesgo de devolver respuestas incorrectas. Mide tu tasa de fallos y ajusta.
La caché de respuestas para consultas comunes también merece la pena. Si los usuarios preguntan repetidamente “¿qué tiempo hace?” o “¿qué hora es?”, guarda en caché el patrón, no solo el prompt exacto:
class ResponseCache:
    def __init__(self):
        self.common_queries = {
            "what is the weather": "Check weather API",
            "what is the time": "Check system time",
            "who is the president": "Check current president",
        }

    def get(self, query: str) -> str | None:
        query_lower = query.lower()
        for common_query, response in self.common_queries.items():
            if common_query in query_lower:
                return response
        return None
Esto no es sofisticado, pero funciona. Las consultas comunes son comunes por una razón.
Cuándo ayuda la optimización
La optimización importa cuando procesas grandes volúmenes, ejecutas cargas de trabajo mixtas o pagas costos de API que se acumulan.
No importa cuando estás prototipando, usando un solo modelo o procesando bajos volúmenes. La complejidad de la presupuestación, el respaldo y la caché no compensa para un sistema que realiza 100 solicitudes al día.
Haz que el flujo básico funcione primero. Añade optimización cuando llegue la factura.
Contraprestaciones
| Estrategia | Coste | Calidad | Complejidad |
|---|---|---|---|
| Sin optimización | Más alto | Consistente | Más baja |
| Presupuestación de tokens | Moderado | Variable | Media |
| Modelos de respaldo | Bajo-Medio | Variable | Media |
| Caché | Más bajo | Alta (para aciertos en caché) | Media |
| Híbrida | Optimizada | Optimizada | Más alta |
Los sistemas de producción suelen ejecutar una estrategia híbrida. Presupuesto por sesión, respaldo según calidad o latencia, y caché de lo que sea posible. La complejidad es real, pero también lo son los ahorros.
Relacionados
- Gravedad de los datos: el verdadero coste de la IA centrada en APIs — por qué el cálculo de equilibrio anterior es solo la mitad de la decisión de autoalojamiento
- La frontera eficiente de los modelos abiertos en 2026 — la economía del tamaño del modelo detrás del punto de equilibrio: un modelo de 27B en una 4090 alquilada frente a los precios actuales de tokens de Sonnet
- Estrategias de enrutamiento de modelos — enrutamiento basado en capacidades, consciente de costos y latencias
- Barreras de seguridad de LLM en la práctica — validación de entrada, filtrado de salida, seguridad
- Diseño de sistemas multi-modelo — arquitectura para múltiples modelos
- Arquitectura de LLM — pilar de diseño de sistemas: enrutamiento, costos, barreras de seguridad y orquestación
