La rétrospective pour l’agent Hermes : mémoire auto-hébergée avec des LLM locaux
Mémoire persistante d’Hermès sur votre propre matériel.
Un agent IA auto-hébergé a besoin de bien plus qu’une fenêtre de contexte longue. Il a besoin d’une manière de retenir des faits utiles, de récupérer des décisions antérieures et de réviser ce qu’il pense savoir à mesure que les projets évoluent.
Hermes Agent est livré avec des fichiers de mémoire intégrés, mais un fournisseur externe peut fournir une récupération beaucoup plus riche entre les sessions. Hindsight est l’une des options plus intéressantes dans ce domaine. Ce guide explique comment l’installer pour Hermes sans inférence cloud, d’abord en tant que conteneur Docker tout-en-un, puis face à un serveur PostgreSQL existant avec des points de terminaison de modèles locaux séparés.
Le guide couvre le déploiement, le choix et la connexion des modèles locaux d’embeddings, de réordonnancement (reranking) et génératifs, le contrôle de ce que auto-retain écrit dans la banque, la connexion à Hermes, et la couche opérationnelle : sauvegarde, migration et hygiène quotidienne de la banque. Les exemples utilisent un schéma de ports délibéré — 8080 pour le serveur principal llama.cpp, 8081 pour les embeddings, 8082 pour le réordonnancement, 11434 pour Ollama — changez-les donc en fonction des ports que vous utilisez déjà et maintenez les petits serveurs sur des ports distincts de celui du modèle principal.
Ce que fait Hindsight
Hindsight est un moteur de mémoire agent persistant avec trois opérations principales : retain (rétention), recall (rappel) et reflect (réflexion). Retain extrait et stocke des informations ; recall combine une récupération sémantique, par mots-clés, par graphe et temporelle ; reflect synthétise une réponse à partir des mémoires accumulées. La consolidation en arrière-plan peut transformer des observations superposées en une couche de connaissance plus utile.
Ce n’est pas simplement une base de données d’embeddings. Un stockage vectoriel peut localiser des passages similaires, mais un système de mémoire doit également préserver la chronologie, les frontières de projet, les preuves contradictoires et les changements de décisions. Ces modes de défaillance sont explorés dans boucles de mémoire auto-renforcées.
Pour le marché plus large, consultez comparaison des fournisseurs de mémoire agent. La mémoire intégrée de Hermes, MEMORY.md, USER.md et les modes mémoire sont couverts dans le guide système de mémoire de Hermes Agent, cet article suppose donc que vous savez comment la couche intégrée fonctionne.
Pourquoi aller au-delà de Mnemosyne
Mnemosyne pour Hermes offre des idées locales attrayantes, y compris le stockage SQLite et la récupération hybride. En pratique, les contraintes d’installation, la compatibilité des versions, le comportement d’approbation d’écriture et les changements rapides autour de ses pré-releases 4.0 peuvent le rendre difficile à exploiter de manière prévisible. Ce sont des préoccupations opérationnelles, pas une preuve que le modèle de mémoire de Mnemosyne est fondamentalement défectueux.
Hindsight n’est pas non plus exempt de dépendances : son image Docker et ses modèles locaux peuvent consommer beaucoup d’espace disque. Exécuter son API en tant que service indépendant, avec l’inférence ailleurs, isole les mises à niveau et le dépannage de l’agent lui-même.
Choisir un déploiement
| Composant | A : Conteneur tout-en-un | B : Serveur PostgreSQL existant |
|---|---|---|
| API et UI Hindsight | Conteneur Docker | Conteneur Docker |
| PostgreSQL | pg0 intégré au conteneur |
Machine PostgreSQL existante |
| LLM génératif | llama.cpp externe | llama.cpp externe |
| Embeddings | Local par défaut ou externe | Ollama ou llama.cpp externe |
| Réordonnancement | Local par défaut ou externe | Serveur de réordonnancement externe |
| Idéal pour | Évaluation rapide | Installation longue durée, isolée |
Ici, « tout-en-un » signifie que l’API, l’UI et la base de données Hindsight sont dans un seul conteneur ; le LLM d’inférence est toujours hébergé ailleurs. C’est intentionnel : l’image officielle Hindsight de Docker n’inclut pas un serveur llama.cpp local génératif prêt à l’emploi.
Utilisez des adresses accessibles sur le LAN, et non localhost, pour les services fonctionnant sur un hôte différent. Restreignez ces ports à des clients de confiance ; les clés dummy des exemples sont des espaces réservés de compatibilité, pas de l’authentification.
Option A : Conteneur Hindsight Tout-en-Un
C’est la manière la plus simple d’évaluer Hindsight sans remplir la VM Hermes avec Python, Torch et des dépendances de modèles locaux. Le conteneur exécute Hindsight et PostgreSQL intégré, tandis que votre LLM llama.cpp principal gère l’extraction et la réflexion mémoire.
Deux étiquettes d’image sont importantes ici. ghcr.io/vectorize-io/hindsight:latest est l’image grande — environ 9 Go sur AMD64 — car elle inclut un embedder BGE, un réordonnanceur MiniLM et PostgreSQL intégré. latest-slim est d’environ 500 Mo et s’attend à ce que ces deux modèles soient ailleurs, ce que vous voulez une fois que vous pointez Hindsight vers la configuration d’embeddings et de réordonnancement dans « Servir et connecter les modèles locaux ». Une fois le test de santé passé, épinglez une étiquette spécifique : une étiquette changeante est un mauvais choix pour une base de données que vous intendez conserver.
Créez un répertoire et un fichier Compose sur l’hôte Hindsight :
mkdir -p ~/services/hindsight
cd ~/services/hindsight
cat > compose.yaml <<'YAML'
services:
  hindsight:
    image: ghcr.io/vectorize-io/hindsight:latest
    container_name: hindsight
    restart: unless-stopped
    shm_size: 1gb
    extra_hosts:
      - "host.docker.internal:host-gateway"
    ports:
      - "8888:8888"  # API Mémoire
      - "9999:9999"  # UI plan de contrôle
    environment:
      HINDSIGHT_API_WORKER_ID: hindsight-standalone
      HINDSIGHT_API_LLM_PROVIDER: openai
      HINDSIGHT_API_LLM_BASE_URL: http://WORKSTATION_IP:8080/v1
      HINDSIGHT_API_LLM_MODEL: LocalMegaLLM
      HINDSIGHT_API_LLM_API_KEY: dummy
      HINDSIGHT_API_LLM_MAX_CONCURRENT: "2"
    volumes:
      - hindsight-pg0:/home/hindsight/.pg0
volumes:
  hindsight-pg0:
YAML
Remplacez WORKSTATION_IP par l’hôte exécutant llama.cpp. Sur Linux, host.docker.internal ne se résout que si le conteneur déclare le mapping host-gateway montré ci-dessus ; sans cela, une URL de base de http://host.docker.internal:8080/v1 ne pointe nulle part. La réservation de mémoire partagée de 1 Go est particulièrement utile pour l’indexation PostgreSQL intégrée ; le petit /dev/shm par défaut de Docker peut provoquer des échecs. Un volume nommé préserve la base de données lorsque le conteneur est recréé, et une alternative avec montage bind doit être propriétaire par l’uid 1000, l’utilisateur à l’intérieur de l’image.
HINDSIGHT_API_WORKER_ID devrait rester stable entre les recréations — la valeur par défaut de Docker est le nom d’hôte du conteneur, et une tâche qui était en cours lorsqu’un conteneur est mort reste bloquée sous l’ancien identifiant de travailleur.
docker compose up -d
docker compose logs -f --tail=100
curl -f http://localhost:8888/health
Si votre version installée de Hindsight expose la santé à un autre chemin, inspectez http://localhost:8888/docs et les journaux du conteneur. Le plan de contrôle est normalement disponible à http://HINDSIGHT_HOST:9999. Une fois le déploiement de base fonctionnel, vous pouvez également pointer ses fournisseurs d’embeddings et de réordonnancement vers la configuration dans « Servir et connecter les modèles locaux » plutôt que de charger les modèles par défaut à l’intérieur du conteneur.
N’exposez pas les ports 8888 ou 9999 directement à Internet. Utilisez un réseau privé ou un reverse proxy authentifié. PostgreSQL intégré est pratique pour les tests, mais une base de données gérée externalement est plus facile à sauvegarder et à maintenir.
Option B : Hindsight Face à un Serveur PostgreSQL Existant
Pour une installation de longue durée, je préfère garder l’API Hindsight, la base de données et les points d’inférence séparés. La VM Hindsight peut rester petite car elle exécute l’orchestration et les services HTTP plutôt que des modèles lourds.
Préparer PostgreSQL et pgvector
Hindsight a besoin de PostgreSQL 14 ou supérieur et d’une extension vectorielle dans la base de données hindsight. L’extension est par base de données : installer le paquet sur le serveur ne fait rien jusqu’à ce que CREATE EXTENSION s’exécute là-bas. Sur un serveur PostgreSQL Debian ou Ubuntu, installez le paquet pgvector correspondant à la version majeure réelle de PostgreSQL ; par exemple, sur PostgreSQL 16 :
sudo apt update
sudo apt install postgresql-16-pgvector
Le nom du paquet et sa disponibilité dépendent de vos dépôts apt configurés. S’il n’est pas disponible, suivez les instructions d’installation de pgvector, ou installez un paquet compatible depuis le dépôt PGDG de PostgreSQL. Ne changez pas aveuglément la version majeure de PostgreSQL sur un serveur partagé.
Créez un rôle dédié et une base de données en tant qu’administrateur PostgreSQL :
CREATE ROLE hindsight LOGIN PASSWORD 'REMPLACEZ_PAR_UN_MOT_DE_PASSE_LONG';
CREATE DATABASE hindsight OWNER hindsight;
Connectez-vous à la nouvelle base de données et activez l’extension :
sudo -u postgres psql -d hindsight -c \
  'CREATE EXTENSION IF NOT EXISTS vector;'
sudo -u postgres psql -d hindsight -c \
  "SELECT extname, extversion FROM pg_extension WHERE extname = 'vector';"
L’extension a normalement besoin de privilèges élevés pour s’installer ; le rôle d’application n’a pas besoin d’être un superutilisateur. Hindsight utilise pgvector par défaut et veut 0.8.0 ou supérieur pour les scans ANN itératifs ; les serveurs plus anciens rejettent ce paramètre. HINDSIGHT_API_VECTOR_EXTENSION peut alternativement sélectionner pgvectorscale (une option DiskANN que Hindsight documente pour les très grandes banques) ou vchord, les deux nécessitant un emballage supplémentaire sur cette construction PostgreSQL exacte. Changer d’algorithmes après que des mémoires existent arrête le démarrage et demande une migration, choisissez donc avant la première rétention. Pour une banque personnelle Hermes, pgvector est celui à installer puis à oublier.
Autorisez uniquement l’hôte Hindsight via pg_hba.conf, par exemple :
host hindsight hindsight 192.168.1.50/32 scram-sha-256
Définissez listen_addresses PostgreSQL de manière appropriée et utilisez TLS ou un réseau privé de confiance pour les connexions inter-hôtes. Sauvegardez cette base de données indépendamment du conteneur Docker Hindsight. Si le serveur est partagé avec d’autres applications, gardez Hindsight dans sa propre base de données, ou définissez HINDSIGHT_API_DATABASE_SCHEMA sur un schéma que vous possédez ; le schéma par défaut est public.
Exécuter Hindsight Contre PostgreSQL
Créez compose.yaml sur la VM Hindsight. Cette version ne démarre délibérément pas PostgreSQL localement :
services:
  hindsight:
    image: ghcr.io/vectorize-io/hindsight:latest-slim
    restart: unless-stopped
    ports:
      - "8888:8888"
      - "9999:9999"
    env_file: .env
    environment:
      HINDSIGHT_API_LLM_PROVIDER: openai
      HINDSIGHT_API_LLM_BASE_URL: http://WORKSTATION_IP:8080/v1
      HINDSIGHT_API_LLM_MODEL: LocalMegaLLM
      HINDSIGHT_API_LLM_API_KEY: dummy
      HINDSIGHT_API_LLM_MAX_CONCURRENT: "2"
      HINDSIGHT_API_DB_POOL_MIN_SIZE: "2"
      HINDSIGHT_API_DB_POOL_MAX_SIZE: "10"
      HINDSIGHT_API_WORKER_ID: hindsight-standalone
Stockez l’URL de base de données externe dans un fichier appelé .env :
HINDSIGHT_API_DATABASE_URL=postgresql://hindsight:VOTRE_MOT_DE_PASSE@POSTGRES_IP:5432/hindsight
chmod 600 .env
docker compose up -d
docker compose logs -f --tail=100
Si votre mot de passe contient @, :, / ou d’autres caractères URL réservés, encodagez-le en URL avant de le mettre dans la chaîne de connexion. Testez que la VM Hindsight peut atteindre le port 5432 de PostgreSQL, et que pg_hba.conf autorise l’hôte Hindsight — un serveur lié uniquement à 127.0.0.1 refuse la connexion même si l’URL semble correcte. Autorisez le premier démarrage à exécuter les migrations de base de données ; les migrations s’exécutent au démarrage sauf si vous définissez HINDSIGHT_API_RUN_MIGRATIONS_ON_STARTUP=false. Avec l’API et la base de données en marche, continuez avec Choisir les modèles pour Hindsight et Servir et connecter les modèles locaux avant de connecter Hermes.
Choisir les modèles pour Hindsight
Le déploiement met l’API et la base de données sur le réseau. La prochaine décision est quels modèles remplissent les trois rôles d’inférence : des embeddings pour les candidats de rappel, un réordonnanceur pour les réordonner, et un LLM génératif pour retain, reflect et la consolidation. Un défaut pratique pour un hôte Hindsight CPU dont le GPU est déjà occupé par la conversation est Qwen/Qwen3-Embedding-0.6B en processus, BAAI/bge-reranker-v2-m3 en processus, et un modèle de chat llama.cpp partagé pour le travail génératif.
Modèles d’embeddings
Hindsight lit la dimension des embeddings au démarrage et dimensionne la banque pour correspondre, donc le modèle que vous choisissez lors de la première rétention est le modèle que la banque conserve jusqu’à ce que vous la reconstruisez. La dimension et le comportement des instructions comptent plus que le classement au leaderboard : un embedder 8B plus fort n’en vaut pas la peine une migration si la banque est déjà de dimension 384 ou 1024. Les lignes ci-dessous sont triées du plus léger au plus lourd ; les figures de RAM sont des empreintes chargées approximatives sur CPU (FP16 / chargement local typique), pas la taille des fichiers GGUF.
| Modèle | Params | Dim | Contexte | Chargé | Fonctionne sur | Notes |
|---|---|---|---|---|---|---|
BAAI/bge-small-en-v1.5 |
33M | 384 | 512 | ~100–130 Mo | CPU | Défaut Hindsight ; fourni dans hindsight:latest. Chemin local le plus rapide. La distribution des scores calibre encore beaucoup de défauts recall_min_scores après l’avoir quitté. |
BAAI/bge-base-en-v1.5 |
109M | 768 | 512 | ~400 Mo | CPU | BGE anglais milieu de gamme ; verrouille une banque de dimension 768. |
sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2 |
~118M | 384 | 512 | ~200 Mo | CPU | MiniLM multilingue documenté par Hindsight ; 50+ langues avec la même largeur de banque 384-dim que BGE-small. |
intfloat/multilingual-e5-small |
~118M | 384 | 512 | ~200 Mo | CPU | Défaut pour le fournisseur onnx ; chemin CPU multilingue léger si vous avez une exportation ONNX. |
nomic-ai/nomic-embed-text-v1.5 |
~137M | 768 | 8k | ~500 Mo | CPU | Embedder Ollama commun ; contexte plus long que BGE classique, toujours anglais d’abord. |
google/embeddinggemma-2 |
270M | 768 | 8k | ~540 Mo | CPU | EmbeddingGemma 2 texte uniquement (désactiver les tours vision/audio). 100+ langues + code ; MRL tronque à 512/256/128 ; préfixes d’instruction pour recherche vs document. Chargement multimodal complet est 740M. |
BAAI/bge-m3 |
568M | 1024 | 8k | ~1,1 Go | CPU ou GPU | Fort encodeur double multilingue ; même largeur que Qwen3-0.6B, donc un remplacement de même dimension nécessite toujours un re-embed complet. |
Qwen/Qwen3-Embedding-0.6B |
0.6B | 1024 | 32k | ~1,2 Go | CPU | Défaut de ce guide. Sensible aux instructions (instruction de recherche côté requête) ; confortable sur CPU. Le fournisseur local applique automatiquement l’instruction ; les serveurs compatibles OpenAI ont besoin de HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX. |
Qwen/Qwen3-Embedding-4B |
4B | 2560 | 32k | ~8 Go FP16 / ~2,5 Go quant | GPU | Niveau de qualité Qwen3 ; verrouille une banque de dimension 2560. Non viable lorsque le GPU conversationnel est déjà saturé. |
La manière dont le modèle est exécuté est l’autre moitié du choix. Les fournisseurs d’embeddings de Hindsight, du plus simple au plus complexe :
| Fournisseur | Comment ça tourne | Idéal quand | Notes |
|---|---|---|---|
local |
SentenceTransformers en processus ; pas de sidecar | Hôte Hindsight unique, embedder CPU | Chemin par défaut. Définissez HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL. Pas de llama.cpp, Ollama ou TEI. |
onnx |
ONNX Runtime en processus | CPU plus léger que Torch ; vous avez déjà une exportation ONNX | Nécessite hindsight-api-slim[local-onnx] et HINDSIGHT_API_EMBEDDINGS_ONNX_*. |
openai / tei |
Point externe compatible OpenAI ou HF TEI | Embeddings hors du processus API ; hôte GPU/CPU partagé | Ce que « Servir et connecter les modèles locaux » configure pour Ollama / llama.cpp / TEI. N’en vaut la peine que si vous voulez l’isolation ou une autre machine. |
Qwen3-Embedding-0.6B n’a pas besoin d’un service d’embeddings externe. Sur un hôte Hindsight CPU, il se charge dans le processus API avec le fournisseur local — Hugging Face télécharge les poids au premier démarrage, et le fournisseur applique lui-même l’instruction de recherche du modèle :
# Environnement Compose (ou clés .env équivalentes)
HINDSIGHT_API_EMBEDDINGS_PROVIDER: local
HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL: Qwen/Qwen3-Embedding-0.6B
Utilisez un point externe compatible OpenAI uniquement si vous voulez l’embedder sur une autre machine ou hors du processus API. Ollama est un tel hôte :
# Embeddings: Qwen3-Embedding-0.6B sur Ollama
HINDSIGHT_API_EMBEDDINGS_PROVIDER: openai
HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL: http://192.168.1.123:11434/v1
HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL: qwen3-embedding:0.6b-q8_0
HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY: dummy
Remplacez l’hôte, le port et l’étiquette par ce que montre ollama list sur votre machine d’inférence.
HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX dépend du fournisseur :
| Chemin | HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX |
HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX |
|---|---|---|
local (Qwen/Qwen3-Embedding-0.6B) |
Laisser non défini / vide — le fournisseur en processus applique lui-même l’instruction de recherche de Qwen | Laisser non défini / vide |
| Ollama / llama.cpp / compatible OpenAI externe | Instruction de récupération officielle Qwen3 (saut de ligne réel avant Query:) |
Laisser vide — les mémoires stockées restent en texte brut |
| Le serveur enveloppe déjà les entrées dans le template de Qwen | Laisser les deux vides — sinon l’instruction est appliquée deux fois | Laisser vide |
Pour le chemin externe, définissez :
# Saut de ligne réel avant Query:. Bash $'...' est la manière fiable de le passer.
HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=
Dans le YAML Compose, la même chaîne a besoin d’un \n explicite (ou d’une valeur multiligne littérale). Définissez les préfixes avant la première rétention : les changer plus tard signifie que les anciens vecteurs et les nouvelles requêtes ne se trouvent plus dans le même espace.
Deux propriétés décident plus que le positionnement au leaderboard. Sensibilité aux instructions : les embeddings Qwen3 appliquent une instruction de recherche côté requête ; sans le préfixe correspondant sur un serveur compatible OpenAI, le côté stocké et le côté requête cessent de se trouver dans le même espace. Verrouillage de dimension : parce que la largeur est lue une fois au démarrage, passer de 0.6B à 4B plus tard est une migration de banque, pas un changement de configuration — et même un remplacement de même dimension (BGE-M3 ↔ Qwen3-0.6B, ou EmbeddingGemma 2 ↔ nomic à 768) change l’espace vectoriel, donc les vecteurs de la banque ne sont pas recalculés automatiquement. Prévoyez une banque neuve ou un re-embed/reindex manuel ; voir Exporter, importer et migrer la banque mémoire. Après avoir quitté BGE-small, testez recall_min_scores contre la nouvelle distribution de scores — les seuils calibrés sur BGE-small peuvent être trop stricts pour Qwen3-0.6B et affamer le réordonnanceur de candidats. Pour les benchmarks et le contexte GGUF/Ollama sur la famille Qwen3, voir Modèles Qwen3 Embedding et Reranker sur Ollama.
Modèles de réordonnancement
Les embeddings rappellent un ensemble de candidats ; le réordonnanceur score chaque paire requête/passage et le réordonne avant que Hindsight ne l’injecte. Avec le fournisseur local, Hindsight charge un cross-encoder SentenceTransformers (ou un réordonnanceur génératif là où supporté). Avec un point externe compatible Cohere, il poste le corps complet de style Cohere vers HINDSIGHT_API_RERANKER_COHERE_BASE_URL. Le réordonnanceur est facultatif, mais une fois l’embedder fixé, c’est souvent la plus grande levier de qualité de rappel — et, sur CPU, souvent la plupart du temps horloge du rappel. Les lignes sont triées du plus léger au plus lourd.
| Modèle | Params | Type | Contexte | Fonctionne sur | Notes |
|---|---|---|---|---|---|
cross-encoder/ms-marco-MiniLM-L-6-v2 |
23M | Cross-encoder | 128 | CPU | Défaut Hindsight ; fourni dans hindsight:latest. Sous la seconde pour ~20 candidats. Garder comme repli nommé si un modèle BGE plus lourd est trop lent. |
cross-encoder/ms-marco-MiniLM-L-12-v2 |
~33M | Cross-encoder | 512 | CPU | Même famille, précision plus élevée ; toujours MS MARCO biaisé anglais. |
cross-encoder/mmarco-mMiniLMv2-L12-H384-v1 |
~33M | Cross-encoder | 512 | CPU | Réordonnanceur MiniLM multilingue documenté par Hindsight. |
BAAI/bge-reranker-base |
278M | Cross-encoder | 512 | CPU | Amélioration modérée sur MiniLM ; en/zh. Discuté souvent ; sauté quand v2-m3 rentre déjà dans le budget de latence. |
BAAI/bge-reranker-v2-m3 |
568M | Cross-encoder | 8k | CPU ou GPU | Défaut multilingue pratique sur CPU. Sur une banque de ~500 mémoires, ~2,6–2,8 s par rappel avec un seuil de 20 candidats (~140 ms/candidat ; ~93–99% du temps de rappel). Plafonds de candidats 20/40/80 ; abaisser le seuil de 20 → 10 divise approximativement le coût de réordonnancement. |
Qwen/Qwen3-Reranker-0.6B |
0.6B | Génératif (token yes) | 32k | GPU préféré | Sensible aux instructions, long contexte. Pas un cross-encoder en drop-in : nécessite un support récent de réordonnanceur génératif de SentenceTransformers, et le scoring /rerank de llama.cpp a des bogues connus de mauvais score (hindsight-benchmarks#11). Valider avant d’adopter. |
BAAI/bge-reranker-v2-gemma |
2.5B | Cross-encoder | 8k | GPU préféré | Qualité multilingue forte ; excessif pour une banque personnelle de quelques centaines de mémoires quand le GPU est déjà plein. |
Qwen/Qwen3-Reranker-4B |
4B | Génératif | 32k | GPU | Candidat Qwen de plus haute qualité ; non viable sans VRAM dédiée. |
Qwen/Qwen3-Reranker-8B |
8B | Génératif | 32k | GPU | Niveau supérieur de la famille ; mêmes avertissements de scoring génératif, plus grand encore. |
Les réordonnanceurs d’API cloud (Cohere, ZeroEntropy, Alibaba qwen3-rerank, TypeSafe, et similaires) fonctionnent dans Hindsight mais envoient le texte mémoire hors boîte. Pour un layout local-only inter-domaine, ils sont hors périmètre.
Deux contraintes opérationnelles dominent le choix. VRAM : si le modèle conversationnel sature déjà le GPU (par exemple un Qwen3.8-27B Q5 sur une carte de 16 Go sans marge), chaque ligne « GPU préféré » est hors de table et le choix live se réduit à MiniLM ou BGE-v2-m3 sur CPU. Nombre de candidats : HINDSIGHT_API_RERANKER_MAX_CANDIDATES (30 dans l’exemple de point externe ci-dessous) limite combien de passages le modèle re-score ; chaque candidat est un passage avant complet, donc coupez le seuil avant de sauter d’un niveau de modèle. Pour Qwen3 via llama.cpp, le GGUF doit garder la tête de classement — un ancien convert_hf_to_gguf.py qui la supprime score tous les passages près de zéro — et même une conversion correcte a toujours besoin d’un test passage connu-bon/connu-mauvais jusqu’à ce que le chemin de scoring génératif soit confirmé.
Niveaux de LLM génératifs
Les modèles d’embeddings et de réordonnancement ne sont pas des substituts pour le LLM génératif utilisé pour extraire et raisonner sur les mémoires. Hindsight prend en charge un LLM par défaut et des remplacements spécifiques à l’opération, qui peuvent cibler le même serveur llama.cpp ou des points indépendants.
| Opération Hindsight | Objectif | Niveau de modèle pratique | Exemples Qwen |
|---|---|---|---|
| Retain | Extraire faits, entités, décisions et chronologie | 4B minimum pour tests ; 9B préféré | Qwen3.5-4B / Qwen3.5-9B |
| Recall | Récupération sémantique, par mots-clés, graphe et temporelle | Pas de LLM génératif requis | Qwen3-Embedding-0.6B + réordonnanceur |
| Reflect | Répondre aux questions en synthétisant les mémoires récupérées | 9B à 27B+ | Qwen3.5-9B / Qwen3.8-27B |
| Consolidation | Réconcilier et compresser les faits liés | 9B préféré | Qwen3.5-9B / Qwen3.8-27B |
| Actualisation du modèle mental | Mettre à jour une compréhension synthétisée de plus longue durée | 9B à 35B | Qwen3.5-9B / Qwen3.6-35B-A3B |
Ce sont des recommandations opérationnelles, pas des nombres de paramètres minimum officiels de Hindsight. Un petit modèle peut extraire correctement un numéro de port mais rater qu’une décision architecturale antérieure a été dépassée. La fiabilité des sorties structurées et la gestion fidèle de la négation comptent plus que le nombre de paramètres nominal seul. Les défauts de température de Hindsight lui-même valent la peine d’être laissés tels quels — 0.1 pour retain, 0.0 pour consolidation, 0.9 pour reflect — et pour retain et consolidation, l’alias non-thinking vaut la peine d’être servi si votre build llama.cpp en a un, parce que les petits checkpoints Qwen3.5 dépensent beaucoup de tokens en mode de réflexion.
Pour un déploiement avec un point llama.cpp existant de Qwen3.8-27B, commencez par le partager entre les tâches génératives Hindsight avec une faible concurrence :
HINDSIGHT_API_LLM_PROVIDER=openai
HINDSIGHT_API_LLM_BASE_URL=http://WORKSTATION_IP:8080/v1
HINDSIGHT_API_LLM_MODEL=LocalMegaLLM
HINDSIGHT_API_LLM_API_KEY=dummy
HINDSIGHT_API_LLM_MAX_CONCURRENT=2
HINDSIGHT_API_RETAIN_LLM_MAX_CONCURRENT=1
HINDSIGHT_API_CONSOLIDATION_LLM_MAX_CONCURRENT=1
Plus tard, routez l’extraction de routine vers un modèle 9B indépendant et réservez le 27B pour la réflexion difficile :
HINDSIGHT_API_RETAIN_LLM_PROVIDER=openai
HINDSIGHT_API_RETAIN_LLM_BASE_URL=http://MEMORY_LLM_HOST:8083/v1
HINDSIGHT_API_RETAIN_LLM_MODEL=MemoryLLM
HINDSIGHT_API_RETAIN_LLM_API_KEY=dummy

HINDSIGHT_API_REFLECT_LLM_PROVIDER=openai
HINDSIGHT_API_REFLECT_LLM_BASE_URL=http://WORKSTATION_IP:8080/v1
HINDSIGHT_API_REFLECT_LLM_MODEL=LocalMegaLLM
HINDSIGHT_API_REFLECT_LLM_API_KEY=dummy
Le petit modèle 4B est économique mais a besoin de tests ; 9B est un compromis qualité/performance sensé. Si retain et consolidation partagent un petit modèle, abaissez HINDSIGHT_API_CONSOLIDATION_LLM_BATCH_SIZE à 2 — le lot par défaut de 8 est un long prompt pour une petite fenêtre de contexte. Qwen3.6-35B-A3B est attrayant pour un serveur d’inférence séparé bien provisionné (c’est un modèle mélange-d’experts avec environ 3 milliards de paramètres actifs, donc budgétisez-le comme un petit modèle actif), tandis qu’un modèle dense 27B est généralement inutile pour chaque événement de retain de routine. Limiter la concurrence en arrière-plan protège le modèle conversationnel Hermes des pics de maintenance mémoire.
Servir et connecter les modèles locaux
Si les réglages d’embeddings et de réordonnanceur local en processus dans Choisir les modèles suffisent, vous pouvez sauter les sous-sections Ollama et llama.cpp externes et sauter à la connexion — ou laisser Compose sur les défauts local montrés là. Les points externes comptent quand l’embedder ou le réordonnanceur devrait vivre sur un autre hôte.
Embeddings externes : Ollama ou llama.cpp
Les embeddings externes sont pour quand vous voulez Qwen3-Embedding-0.6B (ou un autre modèle) sur un hôte séparé. Deux options pratiques sont Ollama, qui gère l’acquisition et le service des modèles avec peu de configuration, et llama.cpp, qui donne un contrôle précis sur la quantification GGUF, les threads CPU, le placement sur appareil et le lot. Le contexte des modèles et les benchmarks pour les deux modèles Qwen3 sont dans Modèles Qwen3 Embedding et Reranker sur Ollama.
Qwen3-Embedding-0.6B retourne des vecteurs de 1024 dimensions, et Hindsight lit cette largeur au démarrage et dimensionne la base de données pour correspondre. Une banque créée avec le modèle BGE intégré de 384 dimensions ne peut pas prendre ce modèle — commencez depuis une base de données ou un volume vide, et décidez le modèle d’embeddings avant la première rétention. Un changement de fournisseur d’embeddings plus tard nécessite de re-embed les enregistrements stockés même si les deux modèles utilisent la même dimension.
Option 1 : Ollama pour Qwen3-Embedding-0.6B
Installez Ollama sur l’hôte d’inférence en utilisant sa documentation d’installation Linux officielle, puis démarrez le modèle d’embeddings :
ollama pull qwen3-embedding:0.6b
ollama serve
Pour un accès distant, configurez OLLAMA_HOST=0.0.0.0:11434 d’Ollama dans son environnement de service, redémarrez le service et protégez-le par pare-feu vers la VM Hindsight — la procédure est couverte dans Accès distant Ollama. Un démon lié uniquement à 127.0.0.1 est invisible pour le conteneur Hindsight. Vérifiez d’abord le nom du modèle avec ollama list, et testez le point d’embeddings standard :
curl http://EMBED_HOST:11434/api/embed \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-embedding:0.6b","input":"A test memory"}'
Le fournisseur d’embeddings OpenAI de Hindsight appelle à la place le point /v1/embeddings compatible OpenAI d’Ollama. Vérifiez que ce point fonctionne avec votre version d’Ollama avant de configurer Hindsight. Ollama est simple pour les embeddings ; ne supposez pas que son API offre un point de réordonnancement compatible. Pour le réordonnancement, préférez le chemin local BGE en processus ci-dessous, ou un point llama.cpp / TEI séparé après avoir validé les scores.
Option 2 : llama.cpp pour Qwen3-Embedding-0.6B
Téléchargez une conversion Qwen3-Embedding-0.6B GGUF vérifiée. Utilisez le nom de fichier GGUF que vous avez réellement téléchargé :
#!/bin/sh
# start-embedding.sh - serveur d'embeddings CPU uniquement
set -eu
cd "$HOME/prj"
exec ./llama.cpp/llama-server \
  --host 0.0.0.0 --port 8081 \
  --model "$HOME/ggufs/Qwen3-Embedding-0.6B-Q8_0.gguf" \
  --alias qwen3-embedding-0.6b \
  --embedding --pooling last \
  --ctx-size 4096 --parallel 1 \
  --threads 4 --threads-batch 4 \
  --batch-size 512 --ubatch-size 256 \
  --n-gpu-layers 0
Les embeddings Qwen3 utilisent le pooling du dernier token, contrairement au pooling CLS utilisé par certains modèles BGE. Un build llama.cpp CPU uniquement est préférable si vous voulez absolument aucune initialisation CUDA sur une station de travail dont le GPU est occupé par un grand modèle conversationnel. N’activez pas --reranking sur ce serveur d’embeddings : cette combinaison est une manière connue d’obtenir un vecteur de zéros.
curl -s http://EMBED_HOST:8081/v1/embeddings \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-embedding-0.6b","input":"A test memory"}' \
  | jq '.data[0].embedding | length'
Une sortie Qwen3-Embedding-0.6B à dimension complète devrait contenir 1024 flottants. Vérifiez que la conversion GGUF et votre gestion d’instructions requête/document Hindsight sont compatibles ; les modèles d’embeddings sensibles aux instructions peuvent perdre en précision lorsqu’ils sont promptés incorrectement.
Réordonnanceur : BGE local ou Qwen3 via llama.cpp
Le réordonnancement est différent des embeddings : le modèle score chaque paire requête/document et retourne un score de pertinence. Sur un hôte Hindsight CPU uniquement — ou quand le GPU conversationnel n’a pas de VRAM libre — le chemin pratique est le fournisseur local de Hindsight avec BAAI/bge-reranker-v2-m3 (ou le défaut MiniLM plus léger). Pas de sidecar requis :
HINDSIGHT_API_RERANKER_PROVIDER=local
HINDSIGHT_API_RERANKER_LOCAL_MODEL=BAAI/bge-reranker-v2-m3
HINDSIGHT_API_RERANKER_MAX_CANDIDATES=20
Qwen3-Reranker-0.6B est un scoreur génératif de token « oui », pas un cross-encoder classique. Il peut être servi à travers llama.cpp avec une conversion GGUF conçue pour le classement, mais traitez ce chemin comme expérimental jusqu’à ce que vous confirmiez les scores sur une paire connu-bon/connu-mauvais : un ancien convert_hf_to_gguf.py qui supprime la tête de classement score tous les passages près de zéro, et le chemin /rerank natif de llama.cpp a des rapports connus de mauvais score pour cette famille.
#!/bin/sh
# start-reranker.sh - GPU ou CPU selon la sélection par --n-gpu-layers
set -eu
cd "$HOME/prj"
exec ./llama.cpp/llama-server \
  --host 0.0.0.0 --port 8082 \
  -model "$HOME/ggufs/Qwen3-Reranker-0.6B-Q8_0.gguf" \
  --alias qwen3-reranker-0.6b \
  --embedding --reranking --pooling rank \
  --ctx-size 4096 --parallel 1 \
  --batch-size 512 --ubatch-size 256 \
  --n-gpu-layers 99
Définissez --n-gpu-layers 0 pour l’exécuter sur CPU. La version GPU a besoin de VRAM supplémentaire pour les tampons de calcul et le contexte, pas seulement les poids du modèle ; évitez de supposer que la taille du fichier est l’allocation GPU totale.
curl -s http://RERANK_HOST:8082/v1/rerank \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-reranker-0.6b", "query":"PostgreSQL storage", "documents":["Hindsight stores memories in PostgreSQL.","A recipe for bread."], "top_n":2}' \
  | jq
Le document PostgreSQL devrait être classé au-dessus du document non lié ; des scores de pertinence tous à zéro signifient que le GGUF est la mauvaise conversion, et le rappel semblera aléatoire même si les faits sont stockés. Vérifiez la forme exacte de results[].index et results[].relevance_score : Hindsight s’attend à une réponse de réordonnancement compatible Cohere, et la compatibilité llama.cpp peut varier entre les builds.
Connecter les points à Hindsight
Ajoutez les réglages d’environnement suivants au service Compose Hindsight, ou stockez-les dans son fichier .env. Choisissez un chemin d’embeddings — local en processus, Ollama, ou llama.cpp — jamais les deux à la fois.
# Option A: Qwen3 en processus sur l'hôte Hindsight (CPU ; pas de sidecar)
HINDSIGHT_API_EMBEDDINGS_PROVIDER=local
HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL=Qwen/Qwen3-Embedding-0.6B

# Option B: service d'embeddings llama.cpp
# HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL=http://EMBED_HOST:8081/v1
# HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL=qwen3-embedding-0.6b
# HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY=dummy
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BATCH_SIZE=8
# HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
# HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=

# Option C: Ollama sur un autre hôte
# HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL=http://192.168.1.40:11434/v1
# HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL=qwen3-embedding:0.6b-q8_0
# HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY=dummy
# HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
# HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=

# Option: réordonnanceur BGE local (pas de sidecar ; préféré sur CPU)
HINDSIGHT_API_RERANKER_PROVIDER=local
HINDSIGHT_API_RERANKER_LOCAL_MODEL=BAAI/bge-reranker-v2-m3
HINDSIGHT_API_RERANKER_MAX_CANDIDATES=20

# Option: point de réordonnancement compatible Cohere llama.cpp (valider d'abord les scores Qwen3)
# HINDSIGHT_API_RERANKER_PROVIDER=cohere
# HINDSIGHT_API_RERANKER_COHERE_BASE_URL=http://RERANK_HOST:8082/v1/rerank
# HINDSIGHT_API_RERANKER_COHERE_MODEL=qwen3-reranker-0.6b
# HINDSIGHT_API_RERANKER_COHERE_API_KEY=dummy
# HINDSIGHT_API_RERANKER_MAX_CANDIDATES=30
Les noms des variables sont spécifiques au fournisseur, et un faux pas est silencieux : HINDSIGHT_API_EMBEDDINGS_BASE_URL est la mauvaise clé, et Hindsight vise silencieusement le point d’embeddings d’OpenAI lui-même au lieu de votre serveur local. Utilisez HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL. Avec le chemin de réordonnanceur compatible Cohere, Hindsight poste le corps complet de style Cohere vers HINDSIGHT_API_RERANKER_COHERE_BASE_URL ; si le journal du conteneur montre un 404 pour /v1/rerank/rerank, votre build ajoute /rerank de lui-même et la valeur devrait s’arrêter à /v1.
Pour les Options B et C, utilisez la valeur de HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX depuis Modèles d’embeddings (l’Option A le laisse non défini). Testez la récupération requête-passage sur vos mémoires réelles après la première rétention.
Contrôler ce qui est retenu
Avec la pile en marche, le mode de défaillance suivant est généralement le chemin d’écriture : Hermes par défaut est auto_retain: true, donc chaque tour de conversation peut être extrait dans la banque. Des erreurs incorrectes, des plans abandonnés et des déclarations exploratoires deviennent des faits consultables, et le rappel ultérieur les traite comme des preuves — la boucle décrite dans boucles de mémoire auto-renforcées. La politique de capture pour Hindsight parmi d’autres fournisseurs est résumée dans comparaison des fournisseurs de mémoire agent.
Modes de capture qui existent aujourd’hui
| Mode | Réglages Hermes / Hindsight | Ce que vous obtenez |
|---|---|---|
| Continu | auto_retain: true, retain_every_n_turns: 1 |
Chaque tour est retenu et extrait |
| Auto par lot | auto_retain: true, augmenter retain_every_n_turns |
Moins de paquets de retain plus grands — toujours automatique, pas une file de revue |
| Explicite uniquement | auto_retain: false + outil hindsight_retain |
Stockage uniquement quand l’agent appelle l’outil (par exemple après que vous dites « retiens ceci ») |
| Synthèse de session | hindsight_retain en fin de session d’un résumé, ou reflect / consolidation de la banque |
Une écriture curatée si vous ou l’agent disciplinez l’appel — pas un flush pour approbation intégré |
Définir auto_retain à false désactive le stockage automatique. Cela n’ajoute pas de boîte de dialogue d’approbation humaine avant chaque écriture. L’agent peut toujours appeler hindsight_retain quand ses outils le permettent ; traitez le retain explicite comme une capture délibérée, pas comme une file en attente.
Le vide de la file d’approbation
Un vœu commun est une file en attente de mémoires candidates que vous revoyez et approuvez avant qu’elles n’entrent dans la banque. Hindsight sous Hermes ne fournit pas ce contrat aujourd’hui. Mnemosyne pour Hermes implémente des écritures par étapes spécifiques au fournisseur dans certaines versions ; ce chemin n’est pas une norme partagée Hermes et ne s’applique pas au plugin Hindsight. Jusqu’à ce qu’un flux d’approbation en amont existe, le modèle praticable est auto_retain: false, un hindsight_retain délibéré, et l’inspection ou la suppression dans l’UI du plan de contrôle Hindsight avant que la prochaine session ne repose sur un fait erroné. Il n’y a pas de clé manquante write_approval pour Hindsight à chercher dans config.json.
Pilotage de la banque (missions, étiquettes, directives, modèles mentaux)
Les gens appellent souvent la couche suivante « finetuning ». Dans Hindsight, c’est surtout de la configuration de banque, pas seulement config.json Hermes : les missions et les réglages d’extraction pilotent ce que retain garde ; les étiquettes structurent les entités ; les directives et les modèles mentaux façonnent la synthèse ultérieure.
| Contrôle | Où ça vit | Comment ça aide |
|---|---|---|
Mission de retain (retain_mission / bank_retain_mission Hermes) |
Config banque | « Faites attention à X, ignorez Y » en langage clair injecté dans l’extraction |
Mode d’extraction (concise, verbose, custom, …) |
Config banque | concise (défaut) garde les faits dignes de long terme ; custom remplace les règles intégrées via retain_custom_instructions |
| Étiquettes d’entité | Config banque | Vocabulaire contrôlé clé:valeur au moment du retain → liens de graphe et étiquettes optionnelles ; améliore la structure de récupération, ne rejette pas par lui-même les déclarations erronées |
| Directives (« règles dures ») | API directives banque | Instructions explicites appliquées pendant reflect (portées par étiquette) ; contraignent la synthèse, pas une porte d’approbation d’écriture |
| Modèles mentaux | API modèle mental banque | Réponses permanentes à des questions récurrentes, actualisées via reflect depuis les mémoires correspondantes ; dérivé, donc de mauvais faits sources les contaminent encore |
| Mission reflect / observations | Config banque | Pilote la synthèse et la consolidation, pas le flux brut de retain |
Les missions, l’extraction concise et les étiquettes réduisent le bruit et améliorent la récupération. Elles ne remplacent pas la désactivation de auto-retain quand la précision compte plus que la complétude. Préférez une mission de retain courte qui nomme les décisions de projet durables et ignore la logistique de chat ; ajoutez des étiquettes d’entité uniquement si vous avez une vraie taxonomie ; ajoutez des modèles mentaux pour deux ou trois questions récurrentes après que la banque détient déjà des faits propres.
Profil d’hygiène recommandé
Un point de départ concret pour une banque personnelle Hermes :
{
  "mode": "local_external",
  "api_url": "http://HINDSIGHT_VM_IP:8888",
  "bank_id": "hermes",
  "memory_mode": "hybrid",
  "auto_recall": true,
  "recall_sync": false,
  "auto_retain": false,
  "retain_async": true,
  "recall_prefetch_method": "recall"
}
Sur la banque, définissez une mission de retain et laissez l’extraction en mode concise (via le plan de contrôle ou l’API Banks). Après un retain explicite, ouvrez l’UI, confirmez l’observation et supprimez les erreurs avant que la consolidation ou l’actualisation du modèle mental ne s’exécute. Laissez recall_prefetch_method sur recall — reflect dépense un appel au modèle de chat avant chaque tour et injecte la synthèse plutôt que les faits sous-jacents.
Connecter Hermes Agent à Hindsight
Sur la VM Hermes, installez le plugin du catalogue, puis exécutez l’assistant de configuration. Sélectionnez Hindsight et le mode local_external ; le plugin n’a pas besoin de démarrer PostgreSQL intégré ou d’exécuter la pile de modèles Hindsight localement, et local_embedded démarrerait un second démon Hindsight à côté du conteneur que vous venez d’exécuter.
hermes plugins install hindsight
hermes memory setup hindsight
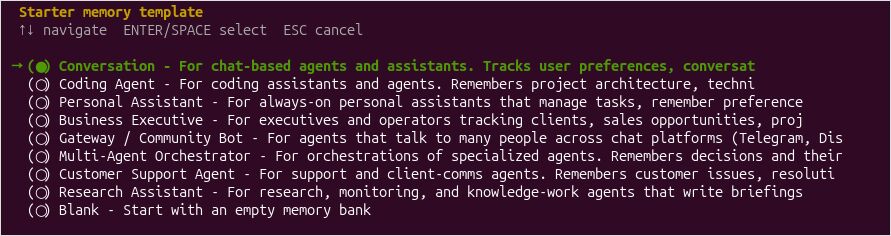
Il y aura un ensemble intéressant d’options de rôle d’agent utilisant hindsight
hermes memory status
La connexion Hindsight externe vit dans ~/.hermes/hindsight/config.json. Une configuration illustrative qui maintient la capture continue (défauts Hermes) est :
{
  "mode": "local_external",
  "api_url": "http://HINDSIGHT_VM_IP:8888",
  "bank_id": "hermes",
  "memory_mode": "hybrid",
  "auto_recall": true,
  "recall_sync": false,
  "auto_retain": true,
  "retain_async": true,
  "retain_every_n_turns": 1
}
Pour un retain explicite uniquement et le pilotage de la banque, utilisez le profil d’hygiène dans Contrôler ce qui est retenu au lieu de laisser auto_retain activé. recall_sync: false priorise la réactivité interactive mais peut injecter le contexte rappelé au tour suivant. Utilisez le rappel synchrone quand la demande actuelle doit incorporer les dernières mémoires avant que le modèle commence à répondre. retain_async: true évite de bloquer les réponses ordinaires pendant que les mémoires sont traitées.
Le défaut de rappel du plugin est les observations uniquement ; les faits bruts du monde et de l’expérience restent dans la banque et hors du prompt jusqu’à ce que la consolidation ait écrit une observation, ou jusqu’à ce que vous élargissiez recall_types à observation,world,experience. L’élargir pour la première semaine et observer le plan de contrôle, puis le restreindre, est un ordre raisonnable.
La mémoire intégrée Hermes reste active à côté du fournisseur ; garder MEMORY.md et USER.md activés pendant que vous apprenez ce que Hindsight ajoute est bien, et l’article sur le système mémoire est l’endroit pour décider si les fichiers plats doivent rester.
Redémarrez la passerelle si elle est déjà en marche :
hermes gateway restart
hermes memory status
Le statut devrait identifier Hindsight comme fournisseur actif. Pour une référence de commandes plus large, y compris la TUI et les commandes de plugin de Hermes, consultez la fiche de triche CLI de Hermes Agent.
Valider la mémoire, pas seulement l’installation
Demandez à Hermes de retenir un fait jetable sur un projet de test, démarrez une autre session et demandez à nouveau ce fait. La rétention est asynchrone par défaut et l’extraction attend le modèle de chat, donc donnez au serveur llama.cpp principal un moment avant de juger. Puis testez un cas plus difficile : dites à Hermes qu’une décision antérieure a changé et demandez quelle décision est actuelle et pourquoi. Vérifiez l’UI de Hindsight et les observations stockées plutôt que de supposer que memory status prouve que l’ingestion et le rappel sont corrects.
Si la réponse revient vide, inspectez le plan de contrôle avant de changer de modèles. Un retain peut réussir et rester invisible au rappel tant que recall_types est limité aux observations et que la consolidation n’a pas tourné — élargir recall_types est le premier contrôle. Un refus de connexion dans le journal du serveur d’embeddings signifie que le conteneur ne peut pas atteindre le port d’embeddings, et des scores de réordonnanceur tous à zéro signifient que le GGUF est la mauvaise conversion.
Les choix du chemin d’écriture (auto_retain, missions, vide d’approbation) sont couverts dans Contrôler ce qui est retenu.
Dépannage et notes opérationnelles
| Symptôme | Cause probable | Premier contrôle |
|---|---|---|
| Hermes dit fournisseur indisponible | Mauvaise URL local_external ou règle réseau |
curl http://HINDSIGHT_VM_IP:8888/health |
| Docker démarre, erreurs PostgreSQL | Extension manquante, mauvais identifiants, ou mémoire partagée insuffisante | Journaux du conteneur et pg_extension |
| Les embeddings retournent 401 ou 404 | URL compatible OpenAI incorrecte, mauvais nom de clé d’env, ou décalage d’alias de modèle | Test direct /v1/embeddings et noms de variables |
| Le réordonnancement échoue | Décalage de point ou de format de réponse, y compris le chemin /rerank doublé |
Test direct /v1/rerank et journal du conteneur |
| Le rappel ne retourne rien d’utilisable | recall_types limité aux observations, ou scores de réordonnanceur à zéro |
Plan de contrôle, puis recall_types, puis conversion du réordonnanceur |
| Une banque existante signale un décalage de dimension | Modèle d’embeddings changé | Reconstruire les vecteurs/réimporter avec un modèle cohérent |
| Les réponses Hermes ralentissent | Rappel synchrone ou concurrence partagée LLM | Désactiver le rappel synchrone ; plafonner la concurrence de retain |
| Des mémoires non liées se répètent | Extraction faible, récupération bruyante, ou consolidation insuffisante | Inspecter les observations et les scores de pertinence |
Un petit déploiement pratique est de 2 à 4 vCPUs et 4 à 6 Go de RAM pour la VM API Hindsight quand PostgreSQL et toute l’inférence sont externes. L’allocation disque dépend toujours de l’image Docker choisie et des couches d’image retenues ; allouez environ 30 à 40 Go initialement avec de la marge pour s’étendre. Dimensionnez l’hôte PostgreSQL en fonction du volume mémoire réel, de la performance de stockage et des autres bases de données qu’il sert.
Sauvegarder et restaurer la banque Hindsight
La banque mémoire est le seul état qui compte, et elle vit dans PostgreSQL. Dans l’Option B, c’est une base de données que vous administrez ; dans l’Option A, c’est le volume nommé pg0 intégré dans le conteneur. Sauvegardez-la indépendamment du conteneur Hindsight — recréer le conteneur sans d’abord capturer le volume ou la base de données supprime la banque, et hermes backup n’atteint pas une banque fonctionnant dans un service séparé.
Option B — PostgreSQL externe. Déversez la base de données hindsight au format personnalisé, puis restaurez-la dans une base de données éphémère pour vérifier l’archive avant de lui faire confiance :
pg_dump -h POSTGRES_IP -U hindsight -Fc hindsight > hindsight-bank.dump

# restaurer dans une base de données éphémère pour prouver que le déversement est utilisable
createdb -h POSTGRES_IP -U postgres hindsight-verify
pg_restore -h POSTGRES_IP -U postgres -d hindsight-verify hindsight-bank.dump
Confirmez que l’extension pgvector et un rappel d’échantillon existent dans la copie restaurée avant de supprimer la cible du déversement original. Gardez le déversement sur un hôte différent de la VM Hindsight, et exécutez ceci en tant qu’administrateur PostgreSQL (un rôle qui peut créer des bases de données) plutôt que le rôle d’application.
Option A — conteneur tout-en-un. La base de données intégrée est un volume nommé, donc arrêtez le conteneur et tarez le volume via une image jetable :
docker stop hindsight
docker run --rm -v hindsight-pg0:/data -v "$PWD":/backup alpine \
  tar czf /backup/hindsight-bank.tgz -C /data .
docker start hindsight
Le point de montage à l’intérieur du conteneur tar (/data) est arbitraire ; il aliasse simplement le volume nommé pour que tar puisse le lire. Pour restaurer, arrêtez le conteneur, videz le volume et détarez l’archive à l’intérieur, ou pointez le conteneur vers la restauration PostgreSQL externe de l’Option B.
Prenez une instantanée à trois moments plutôt que sur un calendrier : avant de changer le modèle d’embeddings, avant une mise à niveau majeure de Hindsight ou PostgreSQL, et avant un passage reflect ou de consolidation qui réécrit la banque. Une sauvegarde que vous avez restaurée dans une banque éphémère vaut plus qu’une que vous n’avez qu’écrite.
Exporter, importer et migrer la banque mémoire
La sauvegarde et la restauration protègent la banque sur place. L’export/import la déplace entre les instances Hindsight, et c’est ce qu’un changement de modèle vous force réellement à faire.
Changer le modèle d’embeddings n’est pas une édition de configuration. Les vecteurs dans la banque ont été calculés avec l’ancien modèle, et un modèle différent — par exemple l’embedder BGE intégré de 384 dimensions contre Qwen3-Embedding-0.6B de 1024 dimensions — écrit dans un espace différent et généralement une largeur différente. Vous ne pouvez pas repointer l’instance existante vers le nouvel embedder et garder les anciens vecteurs ; les dimensions doivent être recalculées en re-embeddant chaque mémoire avec le nouveau modèle d’embeddings.
Parce que l’embedder et sa configuration sont définis par instance Hindsight, le chemin propre est de mettre en place une nouvelle instance avec la nouvelle configuration d’embeddings et de migrer la banque vers elle, plutôt que de reconstruire les vecteurs à l’intérieur de celle qui sert déjà le rappel. L’API Hindsight peut également déplacer la banque, mais pour un changement ponctuel, l’export/import est la voie plus facile et plus inspectable :
# exporter la banque depuis l'ancienne instance
docker exec hindsight \
  hindsight-admin export-bank \
    --bank hermes2 \
    --output /tmp/hermes2.zip

docker cp hindsight:/tmp/hermes2.zip ./hermes2.zip

ls -lh hermes2.zip
unzip -t hermes2.zip

# importer la banque dans la nouvelle instance
docker cp ./hermes2.zip hindsight-q06:/tmp/hermes2.zip

docker exec hindsight-q06 \
  hindsight-admin import-bank \
    --archive /tmp/hermes2.zip
unzip -t vérifie l’archive avant de l’envoyer vers la nouvelle instance. Après l’import, repointez Hermes vers l’api_url de la nouvelle instance dans ~/.hermes/hindsight/config.json, redémarrez la passerelle, et exécutez la validation mémoire d’avant : un fait retenu devrait rappeler à travers le nouvel embedder. Laissez l’ancienne banque et ses vecteurs dans l’ancienne instance jusqu’à ce que la nouvelle se comporte bien, afin d’avoir toujours un repli fonctionnel.
Surveiller, élaguer et garder la banque stable
Avec la banque en marche, le travail quotidien consiste à surveiller ce que le modèle d’extraction a décidé de stocker et à garder l’état dérivé sous contrôle. Utilisez l’UI du plan de contrôle (hindsight-embed -p hermes ui start) pour inspecter les observations, les scores de pertinence et la sortie de consolidation plutôt que de supposer que memory status prouve que l’ingestion et le rappel sont corrects. Les mémoires dupliquées ou obsolètes sont généralement une extraction faible ou une consolidation sous-exécutée, donc corrigez le niveau d’extraction ou le rythme de consolidation avant d’élargir la récupération.
Deux pièges de maintenance valent la peine d’être testés avant de vous fier à la banque. D’abord, supprimer une observation ne garantit pas que toutes les représentations dérivées disparaissent avec elle — un fait reflect ou une arête de graphe construite à partir d’elle peut survivre à la suppression, donc vérifiez la suppression de bout en bout, la même préoccupation de provenance couverte dans boucles de mémoire auto-renforcées. Deuxièmement, gardez HINDSIGHT_API_WORKER_ID stable entre les recréations et épinglez une étiquette d’image spécifique : une tâche qui était en cours quand le conteneur est mort reste bloquée sous l’ancien identifiant de travailleur, et une étiquette changeante est un mauvais choix pour une base de données que vous intendez conserver.
