
Qwen 3.6 27B et 35B MTP par rapport à la version standard sur GPU 16 Go
MTP vs décodage standard sur RTX 4080 — benchmarks réels
J’ai testé les performances du décodage spéculatif (prédiction multi-tokens, MTP) de Qwen 3.6 27B et 35B sur une RTX 4080 avec 16 Go de VRAM.
Pour une vue d’ensemble plus large des vitesses de tokens et des compromis VRAM sur plus de modèles avec le même matériel, consultez Benchmarks de LLM sur GPU 16 Go avec llama.cpp.
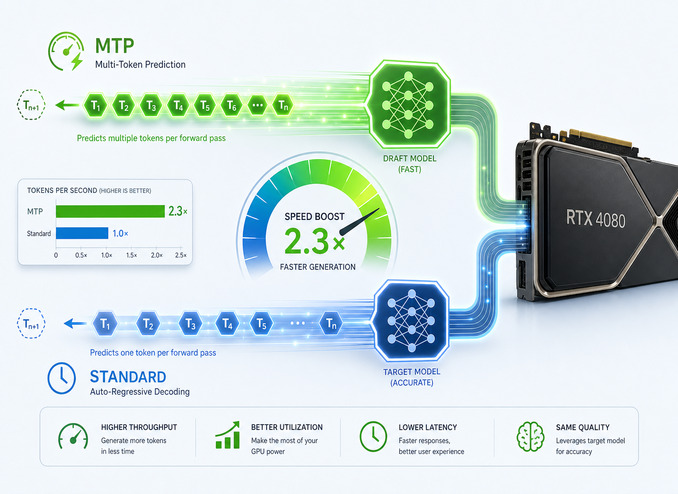
Qu’est-ce que le MTP (Multi-Token Prediction) ?
La prédiction multi-tokens (Multi-Token Prediction) est une forme de décodage spéculatif intégrée directement dans certains checkpoints de modèles. Au lieu de prédire un seul token par passe avant, le modèle possède des « têtes MTP » supplémentaires qui proposent plusieurs tokens futurs en une seule étape, puis les vérifie en parallèle. Si les estimations sont acceptées, le débit effectif augmente sans modifier la qualité de la sortie.
La famille Qwen 3.6 propose à la fois des fichiers GGUF standards et des variantes activées pour le MTP. Dans llama.cpp, le MTP est activé via :
--spec-type draft-mtp --spec-draft-n-max 3
--spec-draft-n-max est le principal réglage. Il définit le nombre de tokens spéculatifs proposés par la tête MTP à chaque étape. Des valeurs plus élevées offrent un gain de vitesse potentiel, mais coûtent de la VRAM supplémentaire pour les tampons de brouillon (draft buffers) — une contrainte réelle sur les cartes de 16 Go.
Ce que j’ai testé et comment
J’ai testé le comportement des deux modèles Qwen 3.6 avec MTP activé par rapport au décodage standard sur un GPU avec 16 Go de VRAM (RTX 4080).
Pour faire tenir les poids du modèle et le cache KV dans la VRAM, j’ai utilisé des variantes fortement quantifiées :
Qwen3.6-27B-UD-IQ3_XXSetQwen3.6-27B-UD-IQ3_XXS-MTPQwen3.6-35B-A3B-UD-IQ3_SetQwen3.6-35B-A3B-UD-IQ3_S-MTP
Deux budgets de contexte sont suivis par exécution :
- Ctx Moy (Contexte moyen) — la taille de contexte à laquelle llama.cpp occupe environ 14,8 Go de VRAM, laissant aux autres applications (Xorg, GNOME Shell, Cursor) un confortable tampon d’environ 500 Mo.
- Ctx Max (Contexte maximum) — le plus grand contexte que llama.cpp pouvait allouer, étant donné que les mêmes applications de bureau occupaient déjà environ 500 Mo de VRAM.
Une raison clé pour maintenir le contexte moyen à une cible pratique est que Hermes Agent — que j’utilise comme assistant IA principal se connectant à llama.cpp sur cette machine — exige au moins 64 K de contexte par défaut et refusera les modèles avec une fenêtre plus petite au démarrage. Les modèles en dessous de ce seuil ne peuvent pas maintenir suffisamment de mémoire de travail pour les flux de travail multi-étapes d’appels d’outils. Pour llama.cpp, cela signifie de passer --ctx-size 65536 ou plus. Toute configuration MTP qui comprime le contexte utilisable moyen de manière significative en dessous de 64 K est donc inadaptée aux charges de travail quotidiennes de Hermes, ce qui explique pourquoi les chiffres de Ctx Moy dans les tableaux ci-dessous sont les plus pertinents pour la prise de décision.
Les deux niveaux de quantification du cache KV ont été testés : q8 (meilleure qualité, plus de VRAM) et q5 (moins de VRAM, contexte plus long). Sachez que le passage d’un cache KV q8 à q5 peut provoquer une chute de qualité notable — dans mes tests, la dégradation était suffisante pour rendre q5 inadapté à mes charges de travail. Les chiffres de vitesse et de contexte pour q5 sont inclus pour exhaustivité, mais vous devriez tester la qualité des réponses sur vos propres tâches avant de vous y engager.
Qwen 3.6 27B MTP vs Standard
Cache KV q8
| MTP max 1 | MTP max 2 | MTP max 3 | MTP max 4 | Standard (IQ3_XXS) | |
|---|---|---|---|---|---|
| Vitesse prompt | 148 t/s | 151 t/s | 148 t/s | 147 t/s | 200 t/s |
| Vitesse gén | 65 t/s | 75 t/s | 73 t/s | 75 t/s | 45 t/s |
| Ctx Moy | 40 K | 40 K | 40 K | 30 K | 80 K |
| Ctx Max | 60 K | 60 K | 60 K | 50 K | 100 K |
Avec un cache KV q8, le MTP à --spec-draft-n-max 2 offre une génération environ 67 % plus rapide (75 vs 45 t/s) au prix de la moitié de la fenêtre de contexte moyenne, passant de 80 K à 40 K. La vitesse d’ingestion du prompt diminue de 200 à environ 150 t/s car le MTP nécessite des transferts périphérique-hôte (device-to-host) pendant la phase de préremplissage (prefill).
Cache KV q5
| MTP max 1 | MTP max 2 | MTP max 3 | MTP max 4 | Standard (IQ3_XXS) | |
|---|---|---|---|---|---|
| Vitesse prompt | 145 t/s | 144 t/s | 141 t/s | 139 t/s | 191 t/s |
| Vitesse gén | 57 t/s | 62 t/s | 67 t/s | 66 t/s | 41 t/s |
| Ctx Moy | 70 K | 60 K | 60 K | 50 K | 130 K |
| Ctx Max | 100 K | 100 K | 90 K | 80 K | 160 K |
Le passage au cache KV q5 permet de récupérer un contexte significatif : --spec-draft-n-max 1 donne un contexte moyen de 70 K à 57 t/s — une accélération de 39 % de la génération par rapport au décodage standard, tout en maintenant la fenêtre de contexte à une taille utile. À --spec-draft-n-max 3, le contexte diminue à 60 K mais la génération atteint 67 t/s (+63 %).
Conclusion pour Qwen 3.6 27B
Le MTP est vraiment utile pour le modèle dense 27B. Le point idéal sur 16 Go de VRAM est :
- KV q8 +
--spec-draft-n-max 2— meilleure vitesse brute (75 t/s), contexte réduit à 40–60 K - KV q5 +
--spec-draft-n-max 1— meilleur équilibre vitesse-contexte (57 t/s, 70 K de contexte moyen)
Qwen 3.6 35B MTP vs Standard
Le modèle 35B est une architecture Mixture-of-Experts (MoE) (35B-A3B signifie 35B de paramètres au total, environ 3B actifs par token). Les modèles MoE bénéficient généralement plus du MTP car le routage creux (sparse routing) maintient la tête MTP peu coûteuse en calcul par rapport à une passe avant complète.
Cache KV q8
| MTP max 1 | MTP max 2 | MTP max 3 | MTP max 4 | Standard (IQ3_S) | |
|---|---|---|---|---|---|
| Vitesse prompt | 277 t/s | 277 t/s | 265 t/s | 275 t/s | 368 t/s |
| Vitesse gén | 186 t/s | 189 t/s | 180 t/s | 171 t/s | 146 t/s |
| Ctx Moy | 15 K | 10 K | — | — | 80 K |
| Ctx Max | 80 K | 70 K | 60 K | 50 K | 150 K |
L’architecture MoE offre une vitesse de génération brute impressionnante avec MTP (+27 % au max 1, +29 % au max 2 vs 146 t/s standard). Mais le problème pratique est le contexte moyen. Avec un cache KV q8, même --spec-draft-n-max 1 ne donne que 15 K de contexte moyen — à peine suffisant pour des tâches modérées. Des profondeurs de brouillon (draft depths) plus élevées n’ont aucun contexte moyen viable du tout sur une carte de 16 Go.
C’est la question centrale du coût VRAM du MTP sur le matériel grand public : les tampons de brouillon supplémentaires grignotent directement le budget VRAM restant, et le modèle 35B-A3B avec un cache KV q8 laisse très peu de marge.
Cache KV q5
| MTP max 1 | MTP max 2 | MTP max 3 | MTP max 4 | Standard (IQ3_S) | |
|---|---|---|---|---|---|
| Vitesse prompt | 264 t/s | 266 t/s | 270 t/s | 264 t/s | 343 t/s |
| Vitesse gén | 151 t/s | 147 t/s | 137 t/s | 131 t/s | 122 t/s |
| Ctx Moy | 10 K | — | — | — | 120 K |
| Ctx Max | 120 K | 110 K | 110 K | 80 K | 200 K |
Le cache KV q5 n’améliore que marginalement la situation du contexte moyen. --spec-draft-n-max 1 donne 10 K de contexte moyen à 151 t/s. Le décodage standard à q5 donne 122 t/s avec 120 K de contexte moyen.
Conclusion pour Qwen 3.6 35B
Sur un GPU de 16 Go, le modèle MoE 35B avec MTP rencontre un mur solide : le contexte utilisable moyen s’effondre à 10–15 K tokens, le rendant impraticable pour des charges de travail réelles. Le décodage standard à 122–146 t/s avec 80–120 K de contexte est nettement plus utile.
Si vous avez plus de 24 Go de VRAM, la combinaison 35B + MTP devient beaucoup plus attractive — le problème de la fenêtre de contexte disparaît et vous conservez le gain de vitesse.
Choisir la bonne valeur pour --spec-draft-n-max
La question du nombre de tokens spéculatifs à proposer par étape (--spec-draft-n-max) n’a pas de réponse unique — cela dépend à la fois de l’architecture du modèle et de la VRAM disponible :
- Pour le 27B dense sur 16 Go :
--spec-draft-n-max 2avec KV q8 est le plus rapide,--spec-draft-n-max 1avec KV q5 est le plus respectueux du contexte. - Pour le 35B MoE sur 16 Go :
--spec-draft-n-max 1est la seule option qui conserve un contexte utilisable, et encore, seulement marginalement. - Les valeurs plus élevées (
3,4) augmentent la pression VRAM sans gains de vitesse proportionnels — au max 4, vous dépensez à peu près la même VRAM supplémentaire qu’au max 2 mais la vitesse de génération ne suit pas.
Comment activer le MTP dans llama.cpp
Assurez-vous d’utiliser un GGUF activé pour le MTP (le nom de fichier contient MTP). Si vous êtes nouveau aux options (flags) de llama.cpp, Le démarrage rapide de llama.cpp avec CLI et Server couvre toutes les bases. Puis lancez llama-server ou llama-cli avec :
llama-server \
  --model Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf \
  --ctx-size 40000 \
  -ngl 99 --flash-attn on \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --spec-type draft-mtp \
  --spec-draft-n-max 2
Pour un cache KV q5, remplacez q8_0 par q5_1 ou q5_0 et ajustez --ctx-size vers le haut :
llama-server \
  --model Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf \
  --ctx-size 80000 \
  -ngl 99 --flash-attn on \
  --cache-type-k q5_1 --cache-type-v q5_1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 1
Le MTP est activé automatiquement dès que llama.cpp détecte les têtes MTP dans le fichier GGUF et que --spec-type draft-mtp est défini.
Ainsi, le Qwen3.6-27B-UD-IQ3_XXS.gguf standard ne fonctionnera pas en mode MTP, vous aurez besoin de Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf.
Mais le Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf peut fonctionner à la fois en mode décodage spéculatif et auto-régressif.
Conclusion
Sur un GPU de 16 Go (RTX 4080), avec ces quantifications, le MTP de llama.cpp est un gain clair pour Qwen 3.6 27B et un bilan négatif pour Qwen 3.6 35B en utilisation pratique :
Qwen 3.6 27B (IQ3_XXS) — le MTP vaut le coup :
- KV q8 + MTP max 2 → génération ~67 % plus rapide, contexte 40–60 K (vs 80–100 K sans MTP)
- KV q5 + MTP max 1 → génération ~39 % plus rapide, contexte 70–100 K (vs 130–160 K sans MTP)
- Bon équilibre entre vitesse et efficacité VRAM à
--spec-draft-n-max 2
Qwen 3.6 35B (IQ3_S) — le MTP n’est pas pratique à 16 Go :
- La vitesse de génération est 27–29 % plus élevée mais le contexte moyen s’effondre à 10–15 K avec q8, et 10 K avec q5
- Le décodage standard à 122–146 t/s avec 80–120 K de contexte est plus utile pour des tâches réelles
- La situation s’améliore considérablement avec plus de 24 Go de VRAM
Sur le papier, le cache KV q5 est la réponse évidente pour maximiser la fenêtre de contexte tout en conservant les gains de vitesse du MTP — mais en pratique, la chute de qualité en passant de q8 à q5 peut être significative. Testez q5 sur vos propres tâches avant de l’adopter ; pour mes charges de travail, la dégradation était inacceptable, et q8 avec un budget de contexte plus serré reste le meilleur compromis.
Pour la vision globale des options de service LLM et des compromis d’infrastructure, consultez le pilier Hébergement LLM en 2026 et Performance LLM en 2026. Où cette classe de 27B se situe sur le spectre taille-coût de 2026, et pourquoi un build actuel Qwen3.8-27B Q4 demande une carte de 24 Go tandis que les mesures ci-dessus restent sur 16 Go, est dans La frontière efficace des modèles ouverts en 2026. Si vous ajustez les paramètres de sampler Qwen 3.6 en même temps que le MTP, Référence des paramètres d’inférence LLM agentique pour Qwen 3.6 et Gemma 4 est un compagnon utile.
