
Conception de systèmes multi-modèles : quand un modèle ne suffit plus
Choisissez le motif le plus simple qui fonctionne.
Les systèmes mono-modèles sont simples. Les systèmes multi-modèles sont puissants. Le défi ne réside pas dans le choix des modèles, mais dans la conception de l’architecture qui les orchestre.
Un système multi-modèles ne consiste pas à posséder plus de modèles. Il s’agit de disposer du bon modèle pour la bonne tâche, au bon moment.
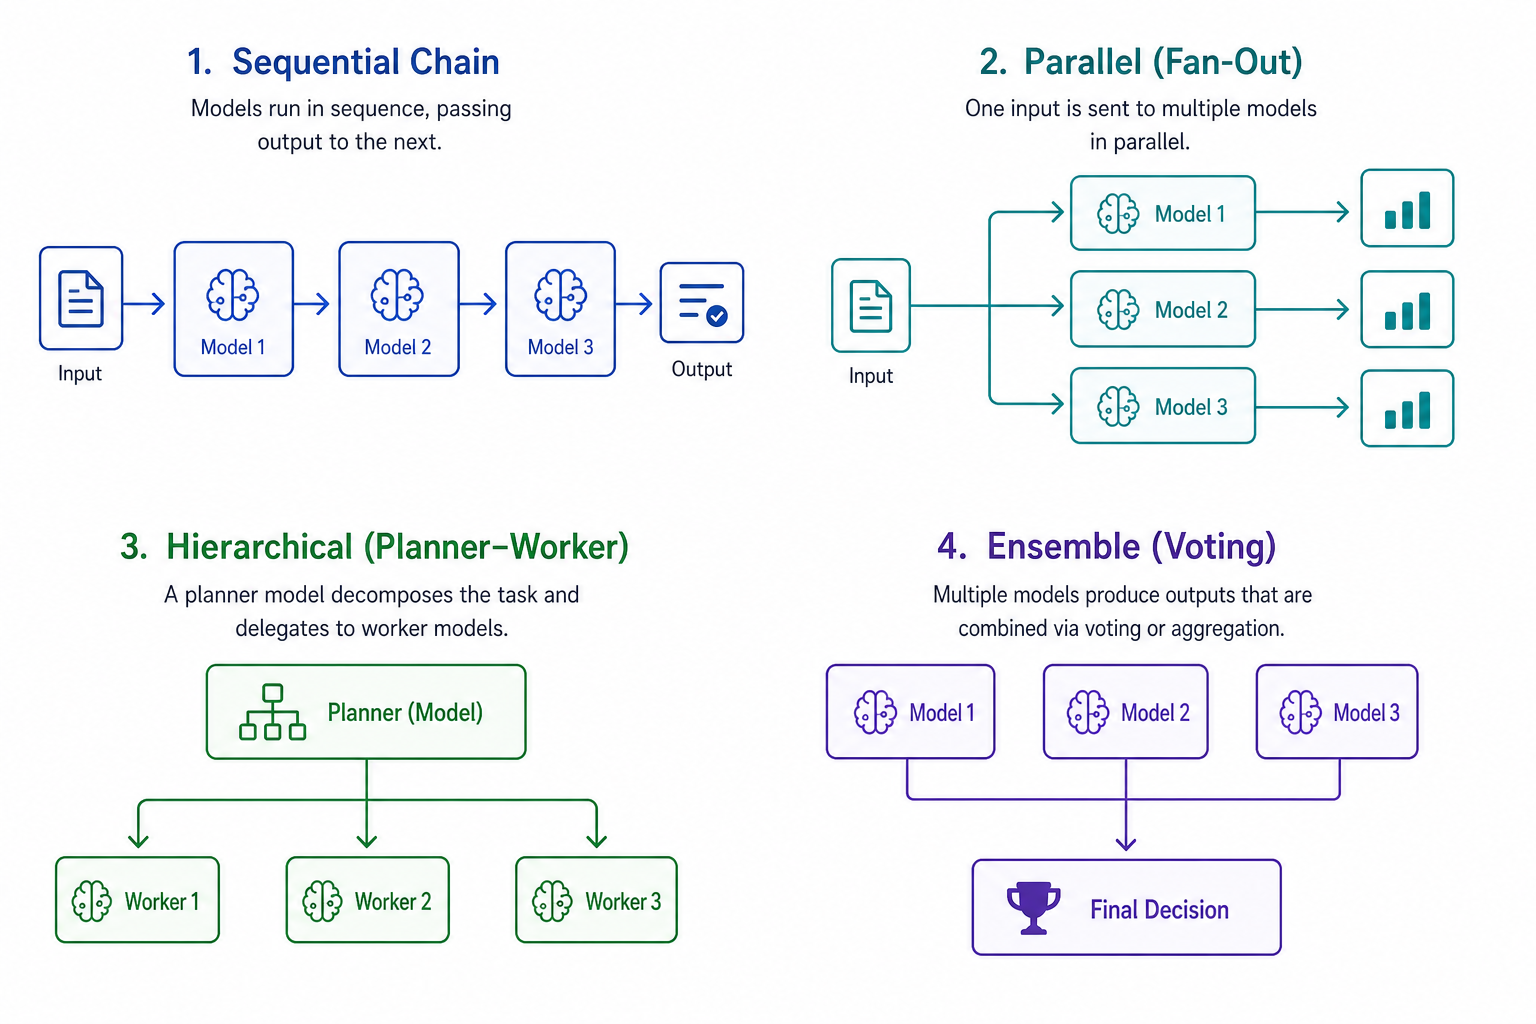
Patterns d’architecture
Cinq patterns couvrent la plupart des cas d’usage :
| Pattern | Complexité | Quand l’utiliser | Compromis |
|---|---|---|---|
| Modèle unique | La plus basse | Prototypage, tâches simples | Capacité limitée |
| Séquentiel | Faible | Flux de travail multi-étapes | Latence plus élevée |
| Parallèle | Moyenne | Tâches indépendantes | Coût plus élevé |
| Hiérarchique | Élevée | Raisonnement complexe | Orchestration complexe |
| Ensemble | La plus élevée | Décisions critiques | Coût le plus élevé |
Choisissez le plus simple qui fonctionne. La complexité est réelle, et elle se cumule.
Architecture séquentielle
Traitez les tâches à travers une chaîne de modèles, chacun se spécialisant dans une étape.
Pattern 1 : Pipeline
Pattern pipeline — la sortie de chaque modèle alimente le suivant :
class ModelPipeline:
    def __init__(self):
        self.models = [
            {"model": "qwen3-1.7b", "task": "classify"},
            {"model": "qwen3-8b", "task": "extract"},
            {"model": "qwen3-32b", "task": "reason"},
        ]

    def process(self, input: str) -> str:
        current = input
        for model_config in self.models:
            current = self.call_model(
                model_config["model"],
                self.create_prompt(model_config["task"], current)
            )
        return current
La latence s’accumule. Trois modèles en série signifient trois fois la latence. N’utilisez ce pattern que si chaque étape nécessite réellement un modèle différent.
Pattern 2 : Routeur
Pattern routeur — classifier la tâche, puis l’affecter au spécialiste :
class ModelRouter:
    def __init__(self):
        self.classifier = "qwen3-1.7b"
        self.specialists = {
            "code": "qwen2.5-coder-7b",
            "math": "qwen3-32b",
            "creative": "claude-sonnet-4",
            "general": "qwen3-8b",
        }

    def route(self, prompt: str) -> str:
        task_type = self.classify(prompt)
        model = self.specialists.get(task_type, self.specialists["general"])
        return self.call_model(model, prompt)
Le classifieur est le maillon faible. S’il classe mal, vous affectez à la mauvaise tâche le modèle incorrect et perdez en qualité. Utilisez un classifieur suffisamment performant — même un petit modèle convient si les catégories sont claires.
Architecture parallèle
Traitez des tâches indépendantes simultanément.
Pattern 1 : Étalement (Fan-Out)
Étalement — exécuter le même prompt à travers plusieurs modèles :
import asyncio

class ModelFanOut:
    def __init__(self):
        self.models = [
            "qwen3-8b",
            "qwen3-32b",
            "claude-sonnet-4",
        ]

    async def process(self, prompt: str) -> list[str]:
        tasks = [self.call_model(model, prompt) for model in self.models]
        return await asyncio.gather(*tasks)
Utile pour les comparaisons, les tests A/B, ou lorsque vous souhaitez sélectionner la meilleure sortie. Coûteux, mais le gain en qualité en vaut la peine pour les décisions critiques.
Pattern 2 : Votation
Votation — combiner les sorties par consensus :
class ModelVoting:
    def __init__(self):
        self.models = [
            "qwen3-8b",
            "qwen3-32b",
            "claude-sonnet-4",
        ]

    def vote(self, prompt: str) -> str:
        responses = [self.call_model(model, prompt) for model in self.models]
        from collections import Counter
        votes = Counter(responses)
        return votes.most_common(1)[0][0]
La majorité simple fonctionne pour la classification. Pour les tâches de génération, c’est plus difficile — il faut une similarité sémantique, et non des correspondances exactes.
Architecture hiérarchique
Utilisez des modèles à différents niveaux d’abstraction.
Pattern 1 : Planificateur-Exécutant
Planificateur-exécutant — un modèle puissant planifie, de plus petits modèles exécutent :
class PlannerExecutor:
    def __init__(self):
        self.planner = "qwen3-32b"
        self.executors = {
            "code": "qwen2.5-coder-7b",
            "search": "qwen3-8b",
            "math": "qwen3-8b",
        }

    def process(self, task: str) -> str:
        plan = self.call_model(self.planner, f"Plan: {task}")
        results = []
        for step in self.parse_plan(plan):
            executor = self.executors.get(step["type"], "qwen3-8b")
            result = self.call_model(executor, step["prompt"])
            results.append(result)
        return self.call_model(self.planner, f"Synthesize: {results}")
Le planificateur fait le travail lourd. Les exécutants gèrent des tâches spécifiques. Ce pattern fonctionne bien lorsque l’étape de planification est coûteuse mais que les étapes d’exécution sont bon marché.
Pattern 2 : Superviseur-Exécutant
Superviseur-exécutant — un superviseur délègue et révise :
class SupervisorWorker:
    def __init__(self):
        self.supervisor = "qwen3-32b"
        self.workers = ["qwen3-8b", "qwen2.5-coder-7b"]

    def process(self, task: str) -> str:
        assignments = self.call_model(self.supervisor, f"Assign: {task}")
        results = []
        for assignment in self.parse_assignments(assignments):
            result = self.call_model(
                assignment["worker"], assignment["task"]
            )
            results.append(result)
        return self.call_model(self.supervisor, f"Review: {results}")
Le superviseur est le goulot d’étranglement. Il planifie, délègue et révise. Assurez-vous qu’il soit suffisamment rapide, sinon tout le système ralentit.
Architecture d’ensemble
Combinez plusieurs modèles pour les décisions critiques.
Pattern 1 : Ensemble pondéré
Ensemble pondéré — noter la sortie de chaque modèle, choisir la plus haute :
class WeightedEnsemble:
    def __init__(self):
        self.models = {
            "qwen3-32b": 0.5,
            "claude-sonnet-4": 0,3,
            "qwen3-8b": 0,2,
        }

    def decide(self, prompt: str) -> str:
        responses = {
            model: self.call_model(model, prompt)
            for model in self.models
        }
        scores = {}
        for model, response in responses.items():
            score = self.evaluate(response) * self.models[model]
            scores[response] = scores.get(response, 0) + score
        return max(scores, key=scores.get)
Les pondérations reflètent votre confiance dans chaque modèle. Ajustez-les en fonction des performances réelles, et non des benchmarks.
Pattern 2 : Ensemble par consensus
Ensemble par consensus — exiger un accord, escalader s’il n’y en a pas :
class ConsensusEnsemble:
    def __init__(self, threshold: float = 0,7):
        self.threshold = threshold
        self.models = [
            "qwen3-32b",
            "claude-sonnet-4",
            "qwen3-8b",
        ]

    def decide(self, prompt: str) -> str:
        responses = [
            self.call_model(model, prompt)
            for model in self.models
        ]
        from collections import Counter
        votes = Counter(responses)
        max_votes = max(votes.values())

        if max_votes / len(self.models) >= self.threshold:
            return votes.most_common(1)[0][0]

        return self.call_model("qwen3-32b", prompt)
Le seuil contrôle la stricte du consensus. 0,7 signifie deux tiers d’accord. Abaissez-le pour des décisions plus rapides, élevez-le pour une confiance plus élevée.
Quand les systèmes multi-modèles ont du sens
Les systèmes multi-modèles ont du sens lorsque vous avez des charges de travail mixtes, besoin d’une haute qualité pour les décisions critiques, ou que vous optimisez le coût ou la latence.
Ils n’ont pas de sens lorsque toutes les tâches ont une complexité similaire, que vous êtes en phase de prototypage, ou que la simplicité prime sur l’optimisation.
La règle générale : commencez avec un modèle. Ajoutez-en d’autres lorsque vous rencontrez une contrainte réelle — coût, latence ou qualité. Ne construisez pas de complexité avant d’en avoir besoin.
Compromis
| Pattern | Coût | Latence | Qualité | Complexité |
|---|---|---|---|---|
| Modèle unique | Le plus bas | La plus basse | Variable | La plus basse |
| Séquentiel | Moyen | Élevée | Élevée | Moyenne |
| Parallèle | Élevé | Basse | Élevée | Moyenne |
| Hiérarchique | Élevé | Élevée | La plus élevée | Élevée |
| Ensemble | Le plus élevé | Moyenne | La plus élevée | La plus élevée |
Chaque pattern implique un compromis. Choisissez celui qui correspond à vos contraintes.
Liens associés
- Stratégies de routage des modèles — routage basé sur les capacités, la prise en compte du coût, la prise en compte de la latence
- Optimisation des coûts pour les systèmes LLM — budgétisation des jetons, modèles de repli, mise en cache
- Garde-fous LLM en pratique — validation des entrées, filtrage des sorties, sécurité
- LLM décisionnels : Quand un modèle doit décider — et quand il ne le doit pas — quelles décisions un modèle peut prendre dans une orchestration, et comment les vérifier
- Architecture LLM — pilier de conception système : routage, coût, garde-fous et orchestration
- Patterns d’orchestration multi-agents — distinct du routage multi-modèles : ceci couvre la manière dont plusieurs agents autonomes se coordonnent, et non la façon dont les tâches sont routées entre les modèles
