
Aiguillage des modèles : cessez d’utiliser un seul modèle pour tout
« Le bon modèle pour la bonne tâche. »
Exécuter un modèle de 70 milliards de paramètres pour résumer un e-mail de 200 mots est une dépense inutile. Utiliser un modèle de 3 milliards de paramètres pour relire du code en production est irresponsable. La plupart des systèmes se situent quelque part entre ces deux extrêmes — et c’est précisément là que le routage de modèles prend tout son sens.
Il s’agit d’adapter la complexité de la tâche à la capacité du modèle. Les compromis sont réels, mais les économies aussi.
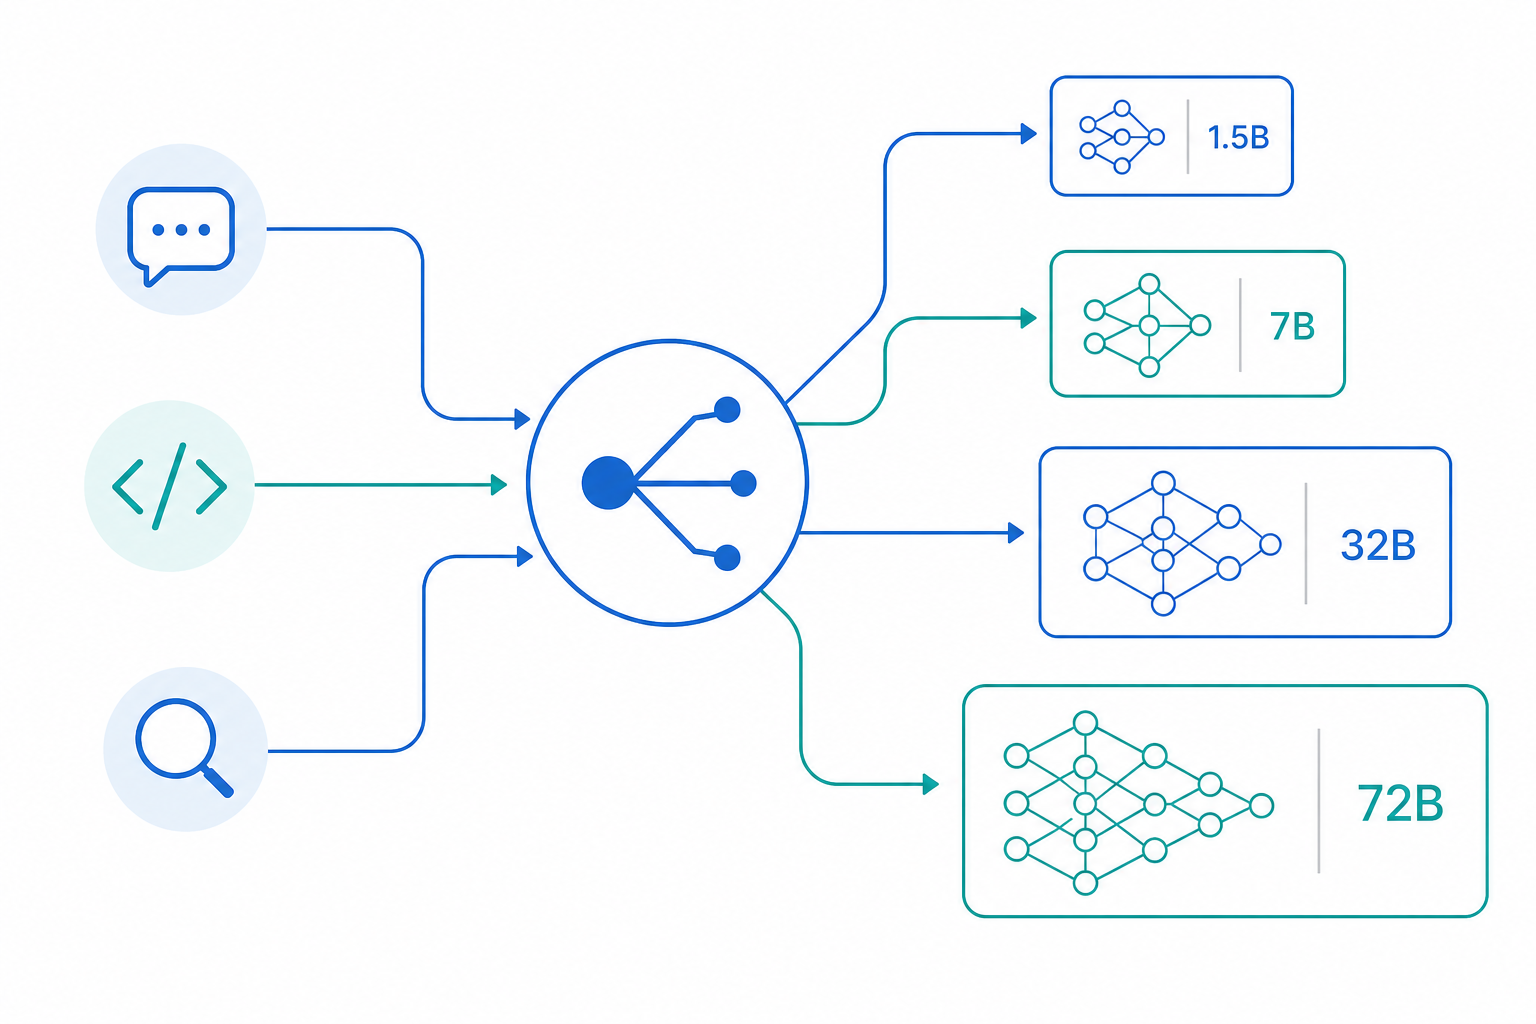
Le problème du routage
Les gens commencent généralement par utiliser un seul modèle et s’y tiennent. Cela fonctionne tant que l’on ne prend pas conscience du coût, de la latence, ou des deux. L’alternative consiste à construire un routeur — un composant qui décide quel modèle traite quelle requête.
Quatre stratégies fonctionnent en pratique :
- Basé sur les capacités — router en fonction de ce que le modèle peut faire
- Tenant compte des coûts — router en fonction de ce que l’on est prêt à dépenser
- Tenant compte de la latence — router en fonction de la rapidité requise
- Hybride — les combiner
Chacune optimise un aspect différent. En choisir une revient généralement à décider de ce qui gêne le plus.
Routage basé sur les capacités
L’approche la plus simple. Classifier la tâche, puis l’envoyer vers le modèle qui la gère.
| Tâche | Taille du modèle | Exemples |
|---|---|---|
| Classification, étiquetage | 1-3B | Qwen3-1.7B, Gemma-2-2B |
| Résumés, extraction | 3-7B | Qwen3-8B, Llama-3.1-8B |
| Génération de code | 7-14B | Qwen2.5-Coder-7B, DeepSeek-Coder-V2 |
| Raisonnement complexe | 14-32B | Qwen3-32B, Llama-3.1-70B |
| Écriture créative, analyse | 32B+ | Qwen2.5-72B, Claude, GPT-4 |
Si la tâche n’a pas besoin du plus gros modèle, ne l’utilisez pas. Un modèle de 1,5B gère sans problème la classification de sentiments. Il n’écrira simplement pas un essai cohérent.
La mise en œuvre est simple :
ROUTING_RULES = {
    "classify": {"model": "qwen3-1.7B", "max_tokens": 100},
    "summarize": {"model": "qwen3-8B", "max_tokens": 500},
    "code_review": {"model": "qwen2.5-coder-7b", "max_tokens": 2000},
    "reason": {"model": "qwen3-32b", "max_tokens": 4000},
    "creative": {"model": "claude-sonnet-4", "max_tokens": 8000},
}

def route_request(task_type: str) -> dict:
    return ROUTING_RULES.get(task_type, ROUTING_RULES["reason"])
L’astuce réside dans la classification elle-même. Si l’on se trompe sur le type de tâche, on route vers le mauvais modèle. J’ai vu des systèmes classer une revue de code comme une « résumaison » et perdre en qualité sans s’en rendre compte.
Routage tenant compte des coûts
L’inférence locale brille ici. Les modèles locaux sont quasiment gratuits une fois l’amortissement du matériel effectué. Une RTX 5080 s’amortit en environ six mois avec une utilisation modérée des API.
| Modèle | Entrée ($/M jetons) | Sortie ($/M jetons) | Coût local/heure |
|---|---|---|---|
| GPT-4o | 2,50 $ | 10,00 $ | — |
| Claude Sonnet 4 | 3,00 $ | 15,00 $ | — |
| Qwen2.5-72B (API) | 0,50 $ | 2,00 $ | — |
| Qwen3-32B (local) | 0,00 $ | 0,00 $ | ~0,10 $ |
| Qwen3-8B (local) | 0,00 $ | 0,00 $ | ~0,05 $ |
Si vous traitez des milliers de requêtes par session, même 0,05 $ d’électricité battent 15 $/M de jetons.
Le routage basé sur le budget dégrade le modèle à mesure que vous dépensez :
class CostAwareRouter:
    def __init__(self, budget_per_session: float = 0.10):
        self.budget = budget_per_session
        self.spent = 0.0
        self.models = {
            "cheap": {"model": "qwen3-8B", "cost": 0.0},
            "medium": {"model": "qwen3-32b", "cost": 0.0},
            "expensive": {"model": "claude-sonnet-4", "cost": 0.000015},
        }

    def route(self, task: str) -> str:
        ratio = self.spent / self.budget
        if ratio < 0.5:
            return self.models["expensive"]["model"]
        elif ratio < 0.8:
            return self.models["medium"]["model"]
        return self.models["cheap"]["model"]
La qualité se dégrade à mesure que l’on régresse. On commence avec Claude, on passe à Qwen3-32B, puis à Qwen3-8B. À la fin d’une longue session, la sortie est nettement moins bonne. Cela dépend de ce que vous construisez.
Router le trafic de routine vers un modèle local tout en réservant l’API pour les cas limites présente également un avantage accessoire au-delà du coût : cela vous évite de glisser vers ce type de gravité des données où chaque fine-tuning et harnais d’évaluation finit par être façonné autour de l’API d’un fournisseur unique.
Routage tenant compte de la latence
Les outils interactifs ont besoin de premiers jetons rapides. Les travaux par lots peuvent attendre. La différence est généralement un facteur de cinq en taille de modèle.
| Cas d’usage | Premier jeton | Complet | Taille max du modèle |
|---|---|---|---|
| Chat en temps réel | < 200 ms | < 2 s | < 7B |
| Outils interactifs | < 500 ms | < 5 s | < 14B |
| Traitement par lots | < 1 s | < 30 s | N’importe quel |
| Recherche/analyse | < 2 s | < 60 s | N’importe quel |
Lorsque vous diffusez des jetons vers un utilisateur, c’est la latence du premier jeton qu’il perçoit. Un modèle de 32B qui met une demi-seconde à démarrer semble lent par rapport à un modèle de 1,5B qui réagit instantanément.
class LatencyAwareRouter:
    def __init__(self):
        self.model_latencies = {
            "qwen3-1.7b": {"first_token": 0.05, "complete": 0.5},
            "qwen3-8B": {"first_token": 0.15, "complete": 2.0},
            "qwen3-32b": {"first_token": 0.5, "complete": 10.0},
            "claude-sonnet-4": {"first_token": 0.3, "complete": 5.0},
        }

    def route(self, target_latency: float) -> str:
        for model, latencies in sorted(
            self.model_latencies.items(),
            key=lambda x: x[1]["complete"]
        ):
            if latencies["complete"] <= target_latency:
                return model
        return "qwen3-1.7b"
Les chiffres de latence sont approximatifs — ils dépendent de votre matériel, de la quantification et de la taille du lot. Mesurez sur votre propre configuration.
Stratégies de repli
Les modèles échouent. Les API limitent les taux de requête. Les dépassements de délai se produisent. Le schéma qui fonctionne est une chaîne de repli, ordonnée du meilleur au plus fiable :
class FallbackRouter:
    def __init__(self):
        self.fallback_chain = [
            {"model": "claude-sonnet-4", "timeout": 30},
            {"model": "qwen2.5-72b", "timeout": 60},
            {"model": "qwen3-32b", "timeout": 120},
            {"model": "qwen3-8b", "timeout": 300},
        ]

    def route_with_fallback(self, prompt: str) -> str:
        for config in self.fallback_chain:
            try:
                return self.call_model(
                    config["model"], prompt,
                    timeout=config["timeout"]
                )
            except (TimeoutError, APIError) as e:
                log.warning(f"Model {config['model']} failed: {e}")
                continue
        raise RuntimeError("All fallback models failed")
Le dernier modèle de la chaîne doit être local. Il est plus lent, mais il n’échouera pas à cause d’un problème réseau ou d’une clé API.
Quand le routage est utile
Le routage a du sens lorsque votre charge de travail est mixte. Si vous effectuez de la classification, des résumés et du raisonnement dans le même système, un routeur fait économiser de l’argent et de la latence.
Il n’a pas de sens lorsque tout ce que vous faites est de la même complexité. Utilisez simplement le modèle qui est bon pour cette tâche. Le routeur ajoute de la complexité dont vous n’avez pas besoin.
Le prototypage initial est une autre raison de s’en passer. Faites fonctionner la tâche avec un seul modèle, puis ajoutez le routage lorsque le coût ou la latence devient réellement un problème.
Compromis
Chaque stratégie de routage optimise quelque chose et sacrifie autre chose :
- Modèle unique — le plus simple, le plus coûteux, qualité constante
- Basé sur les capacités — meilleur coût, meilleure qualité par tâche, complexité modérée
- Tenant compte des coûts — le moins cher, qualité variable, complexité modérée
- Tenant compte de la latence — le plus rapide, peut sacrifier la qualité, complexité modérée
- Hybride — le meilleur de tout, le plus complexe à implémenter
Les systèmes en production convergent généralement vers l’hybride. Commencez par un routage basé sur les capacités, ajoutez la prise en compte des coûts lorsque la facture arrive, ajoutez la prise en compte de la latence lorsque les utilisateurs se plaignent de la lenteur.
Liens associés
- Optimisation des coûts pour les systèmes LLM — budgétisation des jetons, mise en cache, modèles de repli
- Garde-fous LLM en pratique — validation des entrées, filtrage des sorties, sécurité
- Conception de systèmes multi-modèles — architecture pour plusieurs modèles
- LLM décisionnels : Quand un modèle devrait décider — et quand il ne devrait pas — la taxonomie des rôles décisionnels sous-jacente à la sélection des niveaux, avec escalade basée sur la confiance
- Architecture LLM — pilier de conception des systèmes : routage, coûts, garde-fous et orchestration
